کنترل خطا در تشخیص چندبرچسبی ایمنی ویدیو با ATPO
این مقاله روش ATPO را برای تنظیمپذیر کردن موازنه دقت و بازخوانی در تشخیص چندبرچسبی محتوای ناایمن ویدیو معرفی میکند. آزمایشها روی دو بنچمارک نشان میدهند پاداش تطبیقی آن نسبت به پاداشهای ثابت عملکرد بهتری داشته است، اما این یافتهها بر پیشچاپ تکیه دارند و داوری مستقل آن تأیید نشده، و انتخاب نسبت خطا و اعتبارسنجی در سیاست و داده واقعی همچنان ضروری است.
فهرست مطالب
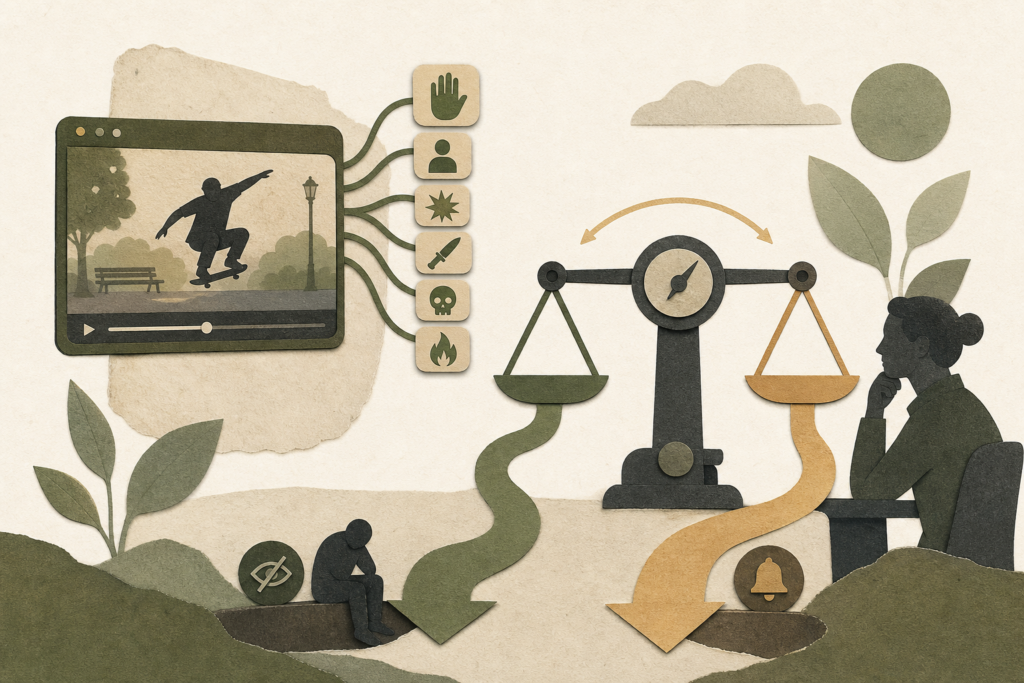
این معرفی بر نسخه موجود در arXiv:2610.02019v1 تکیه دارد؛ وضعیت داوری مستقل آن در این بخش تأیید نشده است. مقاله مسئله تشخیص ایمنی ویدیو را از طبقهبندی دوتایی «ایمن/ناایمن» به تشخیص چندبرچسبی گسترش میدهد: یک ویدیو میتواند همزمان، مثلاً، خشونت و فعالیت غیرقانونی را داشته باشد. نویسندگان میگویند سامانههای تعدیل محتوا به یک نقطه عملیاتی ثابت نیاز ندارند؛ در برخی سیاستها کاهش محتوای آسیبزای ازدسترفته مهمتر است و در برخی دیگر کاهش برچسبگذاری نادرست اهمیت بیشتری دارد.
روش پیشنهادی Adaptive Tversky Policy Optimization یا ATPO، یک چارچوب یادگیری تقویتی بر پایه GRPO است. آموزش ابتدا با یک دوره ریزتنظیم نظارتشده روی مجموعه برچسبهای درست آغاز میشود و سپس با GRPO ادامه مییابد. پاداش بر اساس مثبت درست، مثبت کاذب و منفی کاذب محاسبه میشود. شاخص تورسکی بهطور معمول ضرایب ثابتی برای جریمه مثبت کاذب و منفی کاذب دارد؛ افزایش جریمه مثبت کاذب دقت را برجسته میکند و افزایش جریمه منفی کاذب، بازخوانی را.
نوآوری اصلی، پاداش تورسکی تطبیقی یا ATR است. این پاداش با میانگین متحرک نماییِ خطاهای مثبت کاذب و منفی کاذب، نسبت مشاهدهشده FN/FP را در طول آموزش میسنجد. سپس یک کنترلکننده بازخوردی ضرایب تورسکی را برای نزدیک شدن به نسبت هدفِ تعیینشده توسط کاربر تغییر میدهد. در نسخه G-ATR یک نسبت هدف برای همه دستهها به کار میرود؛ در C-ATR هر دسته کنترلکننده و نسبت هدف جداگانه دارد. بنابراین هدف، تنظیم رفتار آموزش است، نه صرفاً تغییر یک آستانه پس از آموزش.
آزمایشها از SafeWatch-Bench و XD-Violence استفاده میکنند. برای آموزش، از SafeWatch-Bench، ۱۱٬۰۳۶ ویدیوی کاملِ کوتاهتر از دو دقیقه و برای XD-Violence، ۳٬۵۲۰ ویدیوی کوتاهتر از پنج دقیقه انتخاب شده است. ارزیابی بهترتیب روی ۸۲۰ ویدیوی SafeWatch-Bench-Real و ۸۰۰ ویدیوی آزمون XD-Violence انجام شده و مدلهای پایه Qwen2.5-VL-7B-Instruct و Qwen3-VL-8B-Instruct بودهاند. معیارها Jaccard، Micro-F1، Macro-F1 و Binary F1 هستند. در SafeWatch-Bench-Real، Jaccard مدل Qwen2.5-VL-7B از ۴۰٫۶۶ در حالت صفر-نمونه به ۷۵٫۴۴ با ATPO-G رسید؛ ATPO-C به ۷۵٫۱۵ رسید.
مقایسه همشرایط از نقطه شروع SFT یکدورهای نشان میدهد ATPO-G روی SafeWatch-Bench-Real امتیاز Jaccard را از ۷۰٫۰۹ با پاداش تورسکی ثابت به ۷۵٫۴۴ رسانده است؛ روی زیرمجموعه GenAI نیز مقدار ۶۹٫۱۲ به ۷۴٫۲۹ افزایش یافته است. در کنترل سراسری، با افزایش نسبت هدف از ۰٫۲ به ۵، نسبت دقت به بازخوانی از ۰٫۷۷ به ۱٫۱۶ و نسبت FN/FP از ۰٫۳۱ به ۱٫۷۵ حرکت کرده است. در کنترل دستهای نیز برای اطلاعات نادرست، دقت از ۵۵٫۲۸ به ۷۰٫۴۱ و برای محتوای افراطی، بازخوانی از ۷۹٫۰۷ به ۹۴٫۵۷ تغییر کرد؛ همراه با افت دقت دسته افراطی از ۸۰٫۳۱ به ۳۱٫۷۷.
محدودیتها مهماند: ارزیابی فقط بر تعریفها و برچسبهای بنچمارکهای موجود تکیه دارد و مرزهایی مانند خشونت، اطلاعات نادرست یا افراطگرایی ممکن است میان فرهنگها، قانونها و پلتفرمها فرق کند. انتخاب نسبتهای هدف، مقدار جهانی ندارد و به اعتبارسنجی دادهمحور برای کاربرد مشخص نیاز دارد؛ نسبتهای نامناسب میتوانند به تعدیل بیش از حد یا از دست رفتن محتوای آسیبزا منجر شوند. مقاله بازه اطمینان یا آزمون معناداری آماری برای اجرای چندباره گزارش نکرده است. همچنین آموزش RL سهدورهای بهطور میانگین حدود ۲۰ ساعت روی چهار GPU NVIDIA H800 با ۸۰ گیگابایت حافظه طول کشیده است. نویسندگان سامانه را ابزار کمکی برای تصمیمگیری انسانی، نه جایگزین مستقل آن، معرفی میکنند.
This introduction is based on the available arXiv:2610.02019v1 version; its independent peer-review status is not confirmed here. The paper extends video safety detection from binary “safe/unsafe” classification to multi-label detection: a video may simultaneously contain, for example, violence and illegal activity. The authors argue that moderation systems do not need one fixed operating point; some policies prioritize reducing missed harmful content, while others prioritize reducing incorrect flags.
The proposed Adaptive Tversky Policy Optimization, or ATPO, is a reinforcement-learning framework built on GRPO. Training first starts with one epoch of supervised fine-tuning on correct label sets, then continues with GRPO. Rewards are computed from true positives, false positives, and false negatives. The standard Tversky index uses fixed coefficients to penalize false positives and false negatives; increasing the false-positive penalty emphasizes precision, while increasing the false-negative penalty emphasizes recall.
The central contribution is the Adaptive Tversky Reward, or ATR. Using exponential moving averages of false-positive and false-negative errors, it measures the observed FN/FP ratio during training. A feedback controller then changes the Tversky coefficients to approach a user-specified target ratio. G-ATR uses one target ratio across all categories, whereas C-ATR assigns each category its own controller and target ratio. The aim is therefore to adjust training behavior, not merely to change a post-training threshold.
Experiments use SafeWatch-Bench and XD-Violence. Training uses 11,036 complete SafeWatch-Bench videos shorter than two minutes and 3,520 XD-Violence videos shorter than five minutes. Evaluation is conducted on 820 SafeWatch-Bench-Real videos and the 800-video XD-Violence test set, respectively, with Qwen2.5-VL-7B-Instruct and Qwen3-VL-8B-Instruct backbones. Metrics are Jaccard, Micro-F1, Macro-F1, and Binary F1. On SafeWatch-Bench-Real, Qwen2.5-VL-7B Jaccard rises from 40.66 zero-shot to 75.44 with ATPO-G; ATPO-C reaches 75.15.
A matched comparison from the one-epoch SFT initialization shows that ATPO-G raises Jaccard on SafeWatch-Bench-Real from 70.09 with static Tversky reward to 75.44; on the GenAI subset, it rises from 69.12 to 74.29. In global control, increasing the target ratio from 0.2 to 5 moves precision/recall from 0.77 to 1.16 and FN/FP from 0.31 to 1.75. In category-level control, misinformation precision changes from 55.28 to 70.41, while extreme-content recall changes from 79.07 to 94.57, accompanied by a drop in extreme-category precision from 80.31 to 31.77.
Important limitations remain. Evaluation relies only on existing benchmark definitions and annotations, while boundaries for violence, misinformation, or extremism may vary across cultures, laws, and platforms. Target ratios have no universal value and require data-based validation for each use case; unsuitable ratios can cause over-moderation or missed harmful content. The paper reports no confidence intervals or statistical-significance tests across repeated runs. Three RL epochs took about 20 hours on four 80GB NVIDIA H800 GPUs. The authors position the system as an assistive signal for human moderation, not an autonomous replacement for human judgment.
پژوهشهای بیشتری بخوان
مقالات بیشتر درباره هوش مصنوعی و پژوهشهای تازه را ببین.