MOLE: متخصصان نهانی مکمل برای استدلال بصری
MOLE با مسیردهی انتخابی شواهد بصری و تبدیلهای اختصاصی متخصصان نهانی، برای کاهش افزونگی در استدلال بصری نهانی طراحی شده است.
فهرست مطالب
این معرفی بر پیشچاپ arXiv:2610.01917v1، منتشرشده در ۱ اکتبر ۲۰۲۶، تکیه دارد. متن مقاله از داوری همتا یا پذیرش در ژورنال یا کنفرانس خبر نمیدهد؛ بنابراین وضعیت داوری مستقل این پیشچاپ تأییدنشده است و یافتهها باید به همین صورت تلقی شوند. مقاله میگوید در روشهای استدلال بصری نهانی، چند توکن نهانی اغلب به شواهد تصویری یکسان و پروجکشنهای مقدار مشترک دسترسی دارند. بنابراین افزایش شمار توکنها ممکن است بهجای ظرفیت استدلال تازه، نمایشهای تکراری ایجاد کند.
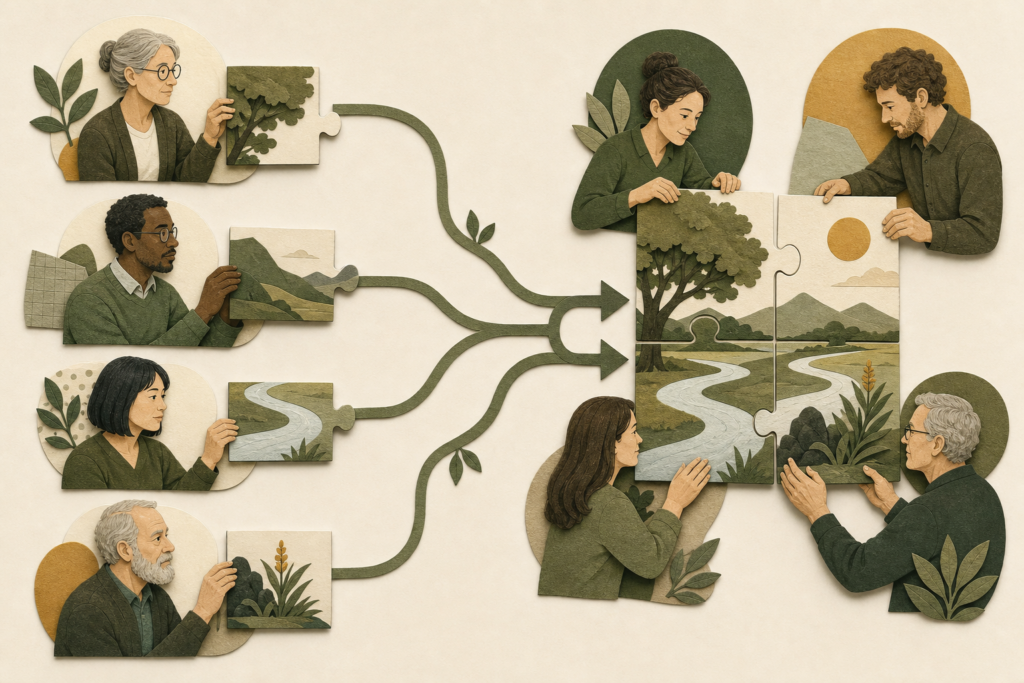
روش پیشنهادی MOLE، یا Mixture of Latent Experts، در هر لایه رمزگشا توکنهای بصری را بهصورت تنک به زیرمجموعهای از متخصصان بصری نهانی میفرستد. هر توکن تصویر، بر اساس امتیاز مسیریاب، K متخصص برتر را انتخاب میکند و اتصالهای دیگر ماسک میشوند. امتیاز مسیریاب نیز بهصورت یک پیشین افزایشی در توجه به کار میرود. در نتیجه، متخصصان لزوماً به مجموعه یکسانی از شواهد دسترسی ندارند.
MOLE همچنین از تبدیل مقدار اختصاصی هر متخصص، یا ESVA، استفاده میکند. این ماژول خروجی پروجکشن مقدار مشترک را نرمالسازی کرده، با یک MLP دولایه ویژه متخصص تغییر میدهد و با مسیر باقیمانده مقیاسدار ترکیب میکند. در پیکربندی پیشفرض، چهار متخصص بصری و چهار متخصص خلاصهساز، مسیریابی Top-K برابر ۲ و بعد پنهان ESVA برابر ۳۲ وجود دارد. متخصصان بصری هنگام استخراج شواهد به یکدیگر توجه نمیکنند؛ متخصصان خلاصهساز نمایشهای آنها را جمع میکنند و توکنهای پاسخ به هر دو گروه دسترسی دارند.
آموزش دو مرحله دارد تا مدل مسیر نهانی را دور نزند. در مرحله اول، توکنهای اعلان و پاسخ نمیتوانند مستقیماً به توکنهای تصویر توجه کنند؛ پس اطلاعات بصری باید از مسیر نهانی عبور کند. در مرحله دوم، این دسترسی مستقیم بازگردانده میشود. هدف آموزش، زیان پیشبینی پاسخ را با زیانهای MoE برای توازن بار و پایداری مسیریاب، و زیان تنوع برای کاهش شباهت تبدیلهای ESVA ترکیب میکند. آزمایش اصلی از Qwen2.5-VL-7B، LoRA و مجموعه آموزشی متوازن ۶۳هزار نمونهای برگرفته از CoVT-Dataset استفاده کرده و رمزگذار بینایی و پروژکتور را ثابت نگه داشته است.
طبق گزارش نویسندگان، روی پنج بنچمارک و شش معیار—CVBench-2D/3D، BLINK، RWQA، V* و F1 در POPE—MOLE میانگین ۷۸٫۶ را ثبت کرده است: ۷۸٫۲، ۸۷٫۸، ۶۳٫۰، ۷۱٫۵، ۸۰٫۶ و ۹۰٫۲. این میانگین، طبق متن، ۴٫۹ امتیاز بالاتر از SFT همداده و ۳٫۶ امتیاز بالاتر از قویترین مبنای نهانی مقایسهشده، LIVR، با بودجه نهانی ۸ است. بهترین پیکربندی ۱۶-توکنی مقایسهشده نیز ۳٫۱ امتیاز پایینتر گزارش شده است. ماسککردن مسیر نهانی، با حفظ دسترسی مستقیم به تصویر، میانگین را ۹٫۲ امتیاز کاهش داده است.
محدودیت مهم این است که شواهد مقاله عمدتاً به همین پنج بنچمارک، داده آموزشی ۶۳هزارنمونهای و خانوادههای Qwen2.5-VL و Qwen3-VL محدود است؛ تعمیم به مدلها، دادهها یا کاربردهای دیگر اثبات نشده است. نتایج GPT-4o و Claude-4-Sonnet از گزارشهای بیرونی با پیکربندی ارزیابی متفاوت آمدهاند و فقط مرجعاند. MOLE نیز هزینه استنتاج را حذف نمیکند: روی RWQA، زمان میانگین حدود ۲۳٪، FLOPs حدود ۰٫۸٪ و حافظه اوج حدود ۱٫۶٪ بیشتر از مدل پایه گزارش شده است. از آنجا که این یافتهها از یک پیشچاپ داورینشدهاند، باید تا تأیید مستقل با احتیاط تفسیر شوند.
This overview is based on preprint arXiv:2610.01917v1, released on October 1, 2026. The paper does not report peer review or acceptance at a journal or conference, so the independent-review status of this preprint is unconfirmed and its findings should be read accordingly. It argues that latent visual reasoning methods often let multiple latent tokens access the same visual evidence through shared value projections. Adding tokens may therefore create redundant representations rather than new reasoning capacity.
The proposed MOLE, or Mixture of Latent Experts, sparsely routes visual tokens to subsets of latent visual experts at every decoder layer. Each image token selects its top-K experts according to router scores, while other connections are masked. Router scores are also used as an additive attention prior. Consequently, experts need not access identical sets of visual evidence.
MOLE also uses an Expert-Specific Value Adapter, or ESVA. It normalizes the shared value-projection output, transforms it through an expert-specific two-layer MLP, and combines it with a scaled residual path. The default configuration has four visual experts, four summary experts, Top-K routing of 2, and an ESVA hidden dimension of 32. Visual experts do not attend to one another during evidence extraction; summary experts aggregate their representations, and answer tokens access both groups.
Training has two stages to prevent the model from bypassing the latent pathway. In Stage 1, prompt and answer tokens cannot directly attend to image tokens, so visual information must pass through the latent route. In Stage 2, direct access is restored. The objective combines answer-prediction loss with MoE losses for load balancing and router stability, plus a diversity loss for ESVA transformations. The main experiment uses Qwen2.5-VL-7B, LoRA, and a balanced 63K-example subset from CoVT-Dataset, while freezing the vision encoder and projector.
As reported by the authors, across five benchmarks and six metrics—CVBench-2D/3D, BLINK, RWQA, V*, and POPE F1—MOLE achieves an average of 78.6: 78.2, 87.8, 63.0, 71.5, 80.6, and 90.2. Per the text, this average is 4.9 points above data-matched SFT and 3.6 above the strongest compared latent baseline, LIVR, at a latent budget of 8. The best compared 16-token configuration is reported as 3.1 points lower. Masking the latent pathway while preserving direct visual access reduced the average by 9.2 points.
An important limitation is that the evidence is mainly limited to these five benchmarks, the 63K-example training set, and the Qwen2.5-VL and Qwen3-VL model families; generalization to other models, data, or applications is not established. GPT-4o and Claude-4-Sonnet results come from external reports using different evaluation configurations and are included only for reference. MOLE also retains inference overhead: on RWQA, the paper reports about 23% higher time, 0.8% higher FLOPs, and 1.6% higher peak memory than the backbone. Because these findings come from an unreviewed preprint, they should be interpreted cautiously pending independent confirmation.
پژوهشهای بیشتری بخوان
مقالات بیشتر درباره هوش مصنوعی و پژوهشهای تازه را ببین.