ارزیابی مسیر تصمیم در workflow هوشمند
در workflow هوشمند، درستبودن پاسخ نهایی کافی نیست. انتخاب ابزار، مسیر شاخهها، guardrail، توقف و handoff را بهصورت مستقل ارزیابی کنید.
فهرست مطالب
این یادداشت با یک اصل ساده شروع میشود: workflow هوشمند را نباید فقط با پاسخ آخر قضاوت کرد. ممکن است خروجی نهایی قابلقبول باشد، اما ایجنت از ابزار اشتباه استفاده کرده، از مسیر نامناسب عبور کرده یا با چند تصمیم پرریسک و غیرقابلتکرار به جواب رسیده باشد. چنین موفقیتی، نشانه قابلاعتمادبودن سیستم نیست.
در n8n یا هر محیط orchestration مشابه، تغییر یک prompt، مدل، ابزار یا node، اصلاحی کوچک محسوب نمیشود. این تغییر میتواند ترتیب tool callها، داده ورودی، منطق route شدن، زمان escalation، تعداد retry و هزینه اجرای فرآیند را عوض کند. اگر فقط جواب آخر را ببینید، ممکن است regression را زمانی متوجه شوید که دیگر به یک خطای عملیاتی تبدیل شده است.
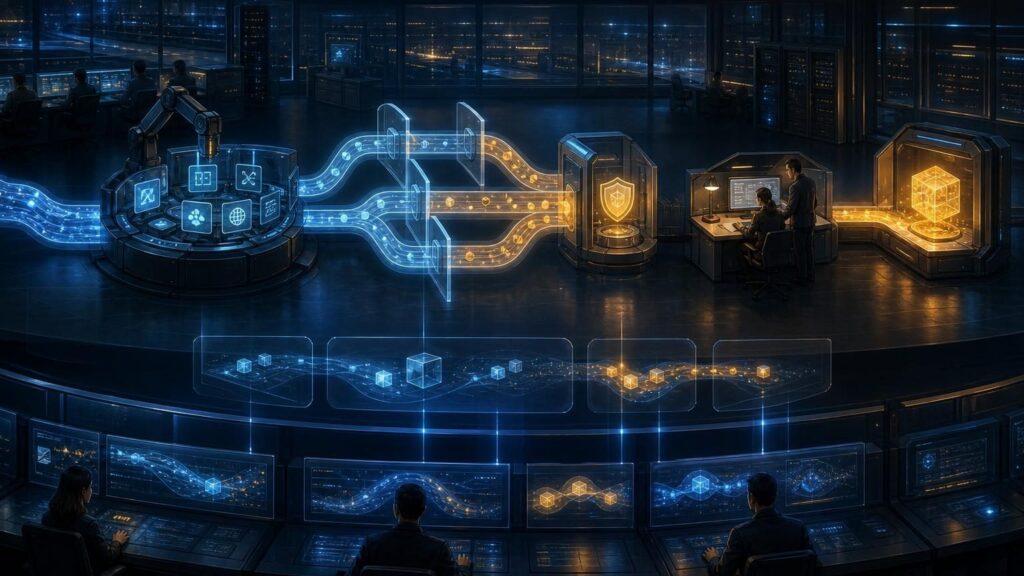
پاسخ نهایی همچنان مهم است و باید یکی از معیارهای اصلی بماند. اما پاسخ، تنها نقطه مشاهده نیست. یک workflow هوشمند از چند تصمیم متوالی ساخته میشود: درخواست دریافت میشود، زمینه بازیابی میشود، ابزار انتخاب میشود، یک شاخه فعال میشود، guardrail ممکن است وارد عمل شود و در برخی موارد، کار به انسان handoff میشود.
این زنجیره را trace یا ردّ اجرای تصمیم در نظر بگیرید. trace فقط یک لاگ فنی برای زمان خطا نیست؛ ماده خام ارزیابی است. در رویکردهای ارزیابی agent، trace نمایی end-to-end از فراخوانی مدل، ابزارها، guardrailها و handoffهاست. پس باید مسیر رسیدن به نتیجه را نمره داد، نه فقط جمله یا خروجی آخر را.
الگوی عملی این است که منطق production را از مسیر evaluation جدا کنید. workflow اصلی باید وظیفه واقعی خود را انجام دهد. مسیر ارزیابی باید نسخههای جدید را روی مجموعهای از نمونههای منتخب اجرا کند، traceها را ذخیره کند و نتیجه را با نسخه مبنا مقایسه کند. تست نباید با داده ناقص یا قواعد آزمایشی، رفتار production را مختل کند.
برای شروع، نیازی به benchmark بسیار بزرگ نیست. میتوان یک مجموعه کوچک از اجرای واقعی و پرریسک ساخت؛ سناریوهایی که انتخاب ابزار اشتباه، route نادرست یا تأخیر در handoff در آنها اهمیت دارد. اگر داده واقعی استفاده میشود، اطلاعات حساس باید حذف، ناشناسسازی یا محافظت شوند. یک مجموعه کوچک و دقیق، از تعداد زیادی مثال تصادفی مفیدتر است.
نمونهها را فقط براساس تفاوت موضوع سؤال انتخاب نکنید. تنوع رفتار مهمتر است. مجموعه تست باید شامل traceهایی باشد که در آنها ایجنت باید ابزار مشخصی را انتخاب کند، از انتخاب ابزار غیرضروری خودداری کند، به شاخه استثنا برود، در زمان درست متوقف شود یا مسئله را به انسان ارجاع دهد.
برای هر trace، پیش از اجرای نسخه جدید، انتظارها را بنویسید. لازم نیست همیشه فقط یک مسیر درست وجود داشته باشد. گاهی چند مسیر قابلقبولاند. اما باید روشن باشد چه چیزی مجاز، ترجیحی یا ممنوع است. برای مثال، بازیابی اطلاعات از پایگاه دانش میتواند مجاز باشد، اما ارسال درخواست به یک سامانه بیرونی بدون تأیید انسانی میتواند ممنوع باشد.
اولین معیار، انتخاب ابزار است. سؤال این است: آیا ابزار درست، در زمان درست و با ورودی مناسب انتخاب شد؟ ابزار موفق لزوماً ابزار درست نیست. ممکن است یک فراخوانی بدون خطای فنی اجرا شود، اما داده قدیمی، ناقص یا خارج از دامنه برگرداند. ارزیابی باید میان انتخاب درست، انتخاب غیرضروری و انتخاب ممنوع تفاوت بگذارد.
معیار دوم، route شدن است. هر شاخه در workflow یک فرض عملیاتی دارد. ممکن است یک مسیر برای ورودی کامل، مسیر دیگر برای داده ناقص و مسیر سوم برای درخواست حساس طراحی شده باشد. بنابراین امتیاز route فقط نباید نشان دهد که node بعدی اجرا شده یا نه؛ باید نشان دهد آیا workflow بر اساس شواهد موجود وارد شاخه مناسب و مجاز شده است یا خیر.
معیار سوم، رفتار guardrail است. guardrail خوب فقط در وضعیت بحرانی ظاهر نمیشود؛ باید در زمان درست فعال شود و بیش از حد هم مسیر کار را متوقف نکند. بررسی کنید محدودیت لازم اعمال شده یا نه، دلیل فعالشدن آن با ورودی هماهنگ بوده یا نه، و workflow پس از آن وارد یک مسیر امن شده یا نه. عبور بیدلیل از guardrail و فعالسازی بیدلیل آن، هر دو خطا هستند.
معیار چهارم، توقف و handoff است. یک ایجنت قابلاعتماد قرار نیست همیشه تلاش کند کار را تا انتها کامل کند. گاهی باید تشخیص دهد که اطلاعات کافی نیست، مجوز لازم وجود ندارد یا ریسک تصمیم بالاست. اگر یک درخواست نیازمند تأیید مسئول مربوطه باشد، پاسخسازی بهترین رفتار نیست؛ ثبت وضعیت، انتقال زمینه لازم و ارجاع سریع میتواند مسیر درست باشد.
کنار این معیارهای رفتاری، معیارهای قطعی هم قرار دهید. زمان اجرا، تعداد tool call، نرخ خطای schema، تعداد retry، فراخوانیهای ناموفق و هزینه تقریبی اجرا، معیارهایی هستند که با قواعد مشخص سنجیده میشوند. اینها جای ارزیابی کیفی را نمیگیرند، اما جلوی این برداشت اشتباه را میگیرند که workflow فقط بهدلیل یک خروجی خوشخوان، سالم و آماده انتشار است.
همه چیز را به یک grader نسپارید. برای ارزیابی agent، ترکیب graderهای کدنویسیشده، مدلمحور و انسانی کاربردیتر است. قواعد کدنویسیشده برای بررسی schema، محدودیتها و ممنوعیتهای قطعی مناسباند. grader مدلمحور میتواند تناسب مسیر با زمینه را بررسی کند. بازبینی انسانی نیز برای موارد خاکستری، استثناها و پیامدهای عملیاتی باقی میماند.
برای ساختن یک امتیاز کلی عجله نکنید. اگر همه معیارها را در یک عدد خلاصه کنید، ممکن است یک خروجی خوب، خطای مهمی در route یا handoff را پنهان کند. ابتدا یک scorecard چندبخشی بسازید: نتیجه نهایی، انتخاب ابزار، route، guardrail، handoff و معیارهای قطعی. سپس برای هر بخش، آستانه جداگانه تعریف کنید.
بعضی خطاها نباید با عملکرد خوب در بخش دیگری جبران شوند. فرض کنید نسخه جدید در کیفیت پاسخ نهایی بهتر است، اما در چند trace حساس دیرتر escalation میکند یا تعداد tool callهای آن بهطور معنادار بالا میرود. این نسخه لزوماً آماده انتشار نیست. مقایسه باید با baseline انجام شود: چه چیزی بهتر شده، چه چیزی بدتر شده و آیا افت رخداده در ناحیهای است که عبور از آن قابلقبول نیست؟
سرعت در این مدل به معنی انتشار عجولانه نیست. سرعت واقعی یعنی یک چرخه کوتاه و تکرارپذیر: تغییر را ثبت کنید، مجموعه trace را اجرا کنید، تفاوت با baseline را ببینید، شکستها را دستهبندی کنید و فقط تغییرهایی را منتشر کنید که از آستانهها عبور کردهاند. این کار، آزمون سریع را از تغییر سریع و بیثبت جدا میکند.
ارزیابی آفلاین و پایش آنلاین باید کنار هم کار کنند. ارزیابی آفلاین برای جلوگیری از regressionهای شناختهشده است. پایش آنلاین برای کشف خطاهایی است که مجموعه تست هنوز آنها را پوشش نمیدهد. هیچکدام جای دیگری را نمیگیرد. traceهای مسئلهدار production، با رعایت حریم خصوصی، میتوانند منبع test caseهای بعدی شوند.
خطاهای پرتکرار یا پرریسک را فقط در گزارش ثبت نکنید. آنها را به تست تبدیل کنید. اگر workflow در یک الگوی مشخص، ابزار نامناسب انتخاب میکند یا handoff را دیر انجام میدهد، همان الگو باید وارد مجموعه ارزیابی شود. هدف این است که خطا در نسخه بعدی فقط دوباره دیده نشود؛ بلکه بتواند انتشار نسخه معیوب را متوقف کند.
شروع عملی میتواند کوچک باشد: یک workflow مهم را انتخاب کنید، traceهای حساس آن را جمع کنید، برای هرکدام چند انتظار رفتاری بنویسید و نسخه بعدی را با baseline مقایسه کنید. لازم نیست همهچیز از روز اول خودکار باشد. تغییر اصلی این است که تیم از سؤال «جواب درست بود؟» به سؤال دقیقتر «آیا workflow به شکلی درست، امن و قابلاعتماد به این جواب رسید؟» برسد.
This article starts with a simple principle: an intelligent workflow should not be judged only by its final answer. The output may look acceptable while the agent used the wrong tool, took an unsuitable path, or reached the answer through risky and non-repeatable decisions. That kind of success is not evidence of a reliable system.
In n8n or any similar orchestration environment, changing a prompt, model, tool, or node is not a small fix. It can alter tool-call order, input data, routing logic, escalation timing, retry count, and execution cost. If you inspect only the final answer, you may notice a regression only after it has turned into an operational failure.
The final answer still matters and should remain a primary metric. But the answer is not the only observation point. An intelligent workflow consists of sequential decisions: a request is received, context is retrieved, a tool is selected, a branch is activated, a guardrail may intervene, and in some cases the work is handed off to a human.
Treat this chain as a trace, or a decision-execution trace. A trace is not merely a technical log for failures; it is raw material for evaluation. In agent-evaluation approaches, a trace is an end-to-end view of model calls, tools, guardrails, and handoffs. The path to a result must therefore be graded, not only the final sentence or output.
A practical pattern is to separate production logic from the evaluation path. The main workflow should perform its real task. The evaluation path should run new versions against a selected set of examples, store traces, and compare results with a baseline version. Testing should not disrupt production behavior with incomplete data or experimental rules.
You do not need a massive benchmark to begin. You can build a small set of real, high-risk executions: scenarios where a wrong tool choice, incorrect route, or delayed handoff matters. If real data is used, sensitive information must be removed, anonymized, or protected. A small and precise set is more useful than a large collection of random examples.
Do not select examples only by differences in question topics. Behavioral diversity matters more. The test set should include traces where the agent must select a specific tool, avoid an unnecessary tool, take an exception branch, stop at the right time, or hand the matter to a human.
For every trace, write the expectations before running a new version. You do not always need a single correct path. Sometimes multiple paths are acceptable. But you need clarity on what is allowed, preferred, or forbidden. For example, retrieving information from a knowledge base may be allowed, while sending a request to an external system without human approval may be forbidden.
The first metric is tool selection. The question is: was the right tool selected at the right time with suitable input? A successful tool is not necessarily the right tool. A call may run without a technical error while returning stale, incomplete, or out-of-scope data. Evaluation must distinguish between a correct choice, an unnecessary choice, and a prohibited choice.
The second metric is routing. Every branch in a workflow carries an operational assumption. One path may be designed for complete input, another for incomplete data, and a third for sensitive requests. A routing score should therefore not merely show whether the next node ran; it should show whether the workflow entered an appropriate and allowed branch based on the available evidence.
The third metric is guardrail behavior. A good guardrail does not appear only in a crisis; it must activate at the right time without unnecessarily stopping work. Check whether the required restriction was applied, whether the reason for activation matched the input, and whether the workflow moved to a safe path afterward. Unjustified guardrail bypasses and unjustified activations are both failures.
The fourth metric is stopping and handoff. A reliable agent is not expected to always complete the work by itself. Sometimes it should recognize that information is insufficient, authorization is missing, or the decision risk is high. If a request requires approval from the responsible person, manufacturing an answer is not the best behavior; recording the status, transferring the needed context, and routing it quickly may be the right path.
Place deterministic metrics alongside these behavioral metrics. Execution time, tool-call count, schema-error rate, retry count, failed calls, and approximate execution cost can be measured using clear rules. They do not replace qualitative evaluation, but they prevent the mistaken belief that a workflow is healthy and ready for release simply because it produces polished output.
Do not assign everything to one grader. For agent evaluation, a combination of code-based, model-based, and human graders is more practical. Code-based rules work well for schemas, hard limits, and explicit prohibitions. A model-based grader can assess whether the path fits the context. Human review remains necessary for gray areas, exceptions, and operational consequences.
Do not rush to create one overall score. If you compress every metric into a single number, a good output may hide a serious routing or handoff error. Start with a multi-part scorecard: final result, tool selection, routing, guardrails, handoff, and deterministic metrics. Then define separate thresholds for each section.
Some failures should not be offset by strong performance elsewhere. Assume a new version improves final-answer quality but escalates later in several sensitive traces or substantially increases tool-call count. That version is not necessarily ready for release. The comparison should be made against the baseline: what improved, what worsened, and did the decline occur in an area where crossing the threshold is unacceptable?
Speed in this model does not mean rushing a release. Real speed means a short, repeatable loop: record the change, run the trace set, inspect differences from the baseline, classify failures, and release only changes that pass the thresholds. This separates rapid testing from rapid, undocumented change.
Offline evaluation and online monitoring should work together. Offline evaluation prevents known regressions. Online monitoring finds failures that the test set does not yet cover. Neither replaces the other. Problematic production traces, collected with privacy protections, can become sources for future test cases.
Do not only record recurring or high-risk failures in a report. Convert them into tests. If a workflow repeatedly chooses an unsuitable tool or performs a handoff too late under a specific pattern, that pattern should enter the evaluation set. The goal is not merely to see the same failure again in the next version; it is to let that failure block the release of a flawed version.
The practical start can be small: choose one important workflow, collect its sensitive traces, write a few behavioral expectations for each, and compare the next version with the baseline. You do not need to automate everything on day one. The key change is moving the team from asking, “Was the answer correct?” to asking the more precise question, “Did the workflow reach this answer correctly, safely, and reliably?”
اگر این موضوع شبیه مسئله واقعی کسبوکار توست، از چکاپ تصمیم شروع کن.
یک مسیر کوتاه برای روشنکردن مسئله، گلوگاه تصمیم و قدم بعدی؛ بدون فرم طولانی و بدون تعهد.