گلوگاه را با زمانسنج پیدا نکنید؛ ردِ کارهای برگشتی را بگیرید
مرحلهای که کند به نظر میرسد، همیشه گلوگاه واقعی نیست. گاهی کار میان دو مرحله آنقدر برمیگردد که کل جریان را از نفس میاندازد.
فهرست مطالب
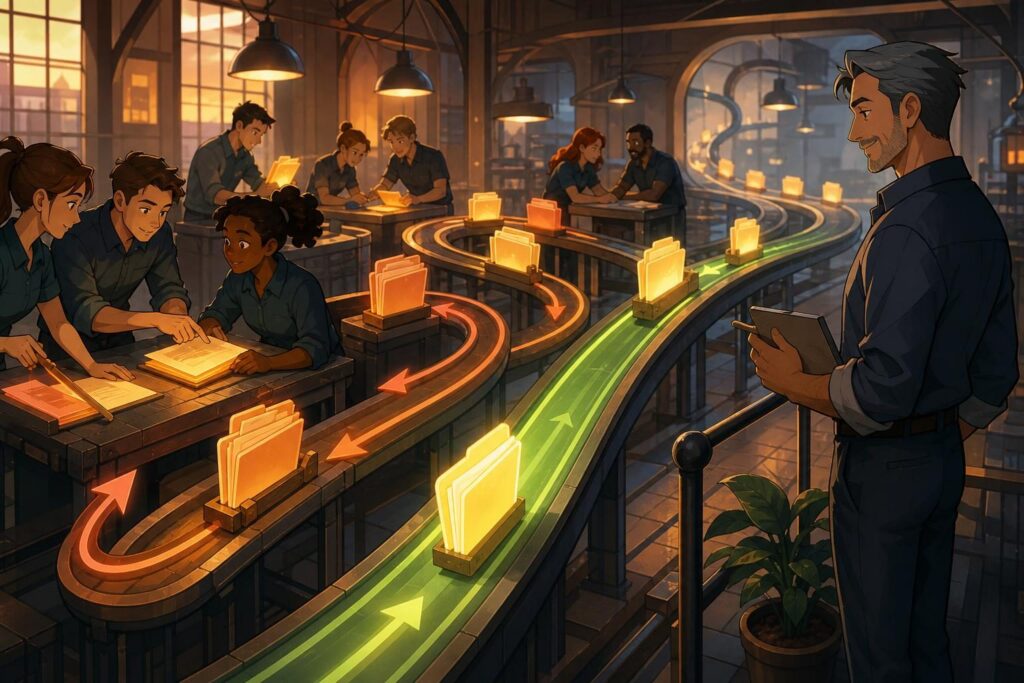
وقتی صحبت از گلوگاه میشود، اولین واکنش بسیاری از مدیران قابل پیشبینی است: زمان هر مرحله را اندازه بگیریم. ببینیم کدام نفر، کدام واحد یا کدام تأیید، بیشتر طول میکشد. این کار بیفایده نیست، اما اغلب ما را به جواب راحتتر میرساند، نه جواب درستتر.
ممکن است یک مرحله واقعاً طولانی باشد، اما هر بار خروجی قابلاستفاده تحویل دهد. در مقابل، مرحلهای که ظاهراً سریع انجام میشود میتواند کل جریان را زمینگیر کند؛ چون خروجیاش ناقص، مبهم یا ناسازگار است و کار را برای اصلاح به عقب برمیگرداند. زمانسنج معمولاً این رفتوبرگشت را خوب نشان نمیدهد.
گلوگاه فقط جایی نیست که کار در آن میایستد. گاهی جایی است که کار از آن عبور میکند، اما درست عبور نمیکند. بعد از چند ساعت یا چند روز، با یک سؤال، یک ایراد، یک فایل ناقص یا یک تصمیم نگرفته دوباره برمیگردد. این همان هزینهای است که در گزارش زمان انجام هر مرحله گم میشود.
در فرایندهای فروش، عملیات، تولید محتوا، خدمات مشتری یا اجرای پروژه، این الگو را زیاد میبینیم. یک تیم میگوید اطلاعات کافی نیست. تیم قبل میگوید درخواست روشن نبوده. مدیر وارد میشود تا استثنا را حل کند. کار اصلاح میشود و دوباره جلو میرود. روی کاغذ همه مشغولاند؛ در عمل، سازمان دارد یک کار را چند بار انجام میدهد.
مشکل اینجاست که دوبارهکاری معمولاً با نام خودش ثبت نمیشود. نامش میشود «هماهنگی»، «بازبینی»، «اصلاح جزئی»، «پیگیری» یا «فقط یک سؤال کوتاه». هر عنوان بهتنهایی بیخطر به نظر میرسد. اما وقتی کنار هم قرار میگیرند، معلوم میشود بخش مهمی از ظرفیت تیم صرف تولید خروجی تازه نشده؛ صرف ترمیم خروجی قبلی شده است.
برای دیدن این مسئله، لازم نیست از روز اول داشبورد پیچیده، نرمافزار جدید یا پروژه تحلیل داده راه بیندازید. یک جریان پرتکرار را انتخاب کنید؛ جریانی که مرتب از چند نفر یا چند واحد عبور میکند و نتیجهاش برای مشتری، درآمد، کیفیت یا اجرای کار مهم است. هرچه جریان تکرارشوندهتر باشد، نشانهها واضحتر خواهند بود.
مثلاً از لحظه دریافت درخواست مشتری تا ارائه پیشنهاد، از ثبت سفارش تا تحویل، یا از تعریف یک کار تا تأیید نهایی آن را انتخاب کنید. قرار نیست همه کسبوکار را یکجا کالبدشکافی کنید. انتخاب یک جریان محدود، احتمال دیدن واقعیت را بیشتر میکند و احتمال ساختن جلسههای بینتیجه را پایین میآورد.
بعد، نقاط تحویل را مشخص کنید. نه فقط نام واحدها را؛ بلکه لحظهای را که یک نفر یا تیم میگوید «سهم من تمام شد، حالا نوبت شماست». این نقطه باید قابل دیدن باشد. یک فرم، تیکت، فایل، پیام ثبتشده یا وضعیت مشخص در ابزار کار میتواند کافی باشد. تحویل شفاهی، برای مدیریت فرایند، حافظه قابلاعتمادی نیست.
برای هر موردی که از یک نقطه تحویل عبور میکند، فقط یک پرسش اضافه کنید: آیا بدون تغییر اساسی پذیرفته شد یا برگشت خورد؟ اگر برگشت خورد، به کجا برگشت و دلیل اعلامشده چه بود؟ هدف در این مرحله محاکمه افراد نیست. هدف این است که مسیر واقعی کار را ببینید، نه مسیری را که در فلوچارت کشیدهاید.
ثبت را ساده نگه دارید. نام کار، نقطه تحویل، پذیرش یا برگشت، علت برگشت و مسئول تصمیم برای ادامه معمولاً کافی است. اگر فرم ثبت آنقدر مفصل باشد که کسی پرش نکند، دادهای ندارید. اگر آنقدر کلی باشد که هر چیز زیر عنوان «اشتباه» برود، باز هم چیزی یاد نمیگیرید.
علتهای برگشت را از همان ابتدا دستهبندی کنید. اطلاعات ناقص، معیار مبهم، خطای اجرایی، تغییر درخواست، نبود اختیار تصمیم، ناسازگاری با استاندارد، و استثنای خارج از مسیر، دستههای کاربردی اولیهای هستند. لازم نیست دستهبندی شما کامل باشد. باید آنقدر روشن باشد که دو نفر، یک اتفاق مشابه را تقریباً در یک دسته ثبت کنند.
خیلی زود متوجه میشوید که همه برگشتها ارزش یکسان ندارند. بعضی برگشتها طبیعیاند؛ مثلاً وقتی مشتری واقعاً درخواستش را تغییر داده است. اما بعضی دیگر نشانه طراحی ضعیف فرایندند؛ مثل وقتی هر بار تیم بعدی مجبور است همان اطلاعات پایه را از نو بپرسد یا هر خروجی پیش از تأیید، چند بار بین دو نفر جابهجا میشود.
اینجا سؤال مهم عوض میشود. بهجای اینکه بپرسید «چه کسی کند است؟»، بپرسید «این خروجی در اولین تحویل، چه چیزی کم داشت که قابلپذیرش نبود؟» این تغییر سؤال ساده به نظر میرسد، اما لحن بحث را از سرزنش فردی به اصلاح سیستم میبرد.
پاسخ معمولاً در تعریفنشدنِ «آماده برای تحویل» پیدا میشود. بسیاری از تیمها تعریف دقیقی از تمامشدن کار ندارند. هرکس کار را بر اساس برداشت خودش تمامشده میداند. یکی میگوید فایل آماده است چون تهیه شده؛ دیگری میگوید آماده نیست چون منبع، تأیید یا اطلاعات لازم را ندارد. هر دو ممکن است از زاویه خودشان حق داشته باشند.
معیار آماده برای تحویل نباید یک سند سنگین و پر از بندهای حقوقی باشد. برای هر نقطه تحویل، چند شرط روشن کافی است: چه اطلاعاتی باید همراه کار باشد، چه تصمیمی باید قبلاً گرفته شده باشد، چه چیزی نباید باقی مانده باشد، و چه کسی حق دارد استثنا را بپذیرد. معیار خوب، جلوی گفتوگو را نمیگیرد؛ جلوی حدسزدن را میگیرد.
اگر یک خروجی مرتب برمیگردد، وسوسه نشوید که فوراً یک نفر دیگر به تیم اضافه کنید، جلسه هماهنگی بیشتر بگذارید یا یک ابزار جدید بخرید. اینها گاهی لازماند، اما اغلب فقط ظرفیت بیشتری برای حمل همان آشفتگی فراهم میکنند. اول باید بفهمید حلقه برگشت کجا بسته میشود و چرا هر بار دوباره فعال میشود.
استثناها را جداگانه نگاه کنید. فرایندی که با استثناهای زیاد جلو میرود، در عمل یک فرایند استاندارد نیست؛ مجموعهای از تصمیمهای موردی است که لباس فرایند پوشیده. اگر یک استثنا تکرار میشود، دیگر استثنا نیست. یا باید به مسیر رسمی تبدیل شود، یا علتش از بین برود، یا آگاهانه متوقف شود.
این نگاه برای اتوماسیون و هوش مصنوعی مهمتر هم میشود. بحثهای اخیر درباره بهرهوری سازمانی هم به همین نکته برمیگردند: افزودن ابزار هوشمند به یک جریان کار شلوغ، معمولاً آشفتگی را حل نمیکند، فقط سرعتش را بالا میبرد. وقتی ورودی مبهم است، معیار پذیرش مشخص نیست و کار مرتب برمیگردد، خودکارسازی فقط سرعت تولید خروجیهای نیازمند اصلاح را بالا میبرد. ابزار ممکن است کار را سریعتر جابهجا کند، اما نمیتواند بهتنهایی درباره معنای «خروجی قابلقبول» توافق بسازد.
قبل از خودکارکردن هر بخش، ببینید چند بار کار در آن نقطه برمیگردد و علت برگشت چیست. اگر علت، نبود داده یا نبود قاعده تصمیم است، اول همان را حل کنید. اگر علت، کار تکراری و روشن است، آنوقت اتوماسیون میتواند مفید باشد. ترتیب این دو موضوع، تفاوت میان ساختن اهرم و ساختن آشفتگی سریعتر است.
پس از چند هفته مشاهده، دنبال یک عدد جادویی نباشید. دنبال الگو باشید: کدام نقطه تحویل بیشترین برگشت را دارد، کدام علت تکرار میشود، چه کسی مجبور است بیشترین ابهام را جمع کند، و کدام تصمیم مرتب به مدیر ارجاع داده میشود. اینها معمولاً تصویری واقعیتر از گلوگاه میدهند تا میانگین زمان انجام کار.
سپس فقط یک حلقه را انتخاب کنید و ببندید. معیار تحویل را روشن کنید، یک تصمیم را به سطح درست واگذار کنید، اطلاعات لازم را زودتر در جریان بگذارید، یا مسیر یک استثنای پرتکرار را مشخص کنید. همزمان سراغ همه مشکلات نروید. فرایندها با تغییرهای کوچک و قابلمشاهده بهتر میشوند، نه با نقشههای بزرگ و فراموششده.
مدیریت گلوگاه، جستوجوی یک نفر مقصر نیست. کار اصلی، کمکردن دفعاتی است که یک خروجی برای قابلاستفاده شدن دوباره به عقب برمیگردد. وقتی حلقههای برگشت کمتر شوند، زمان آزاد میشود، تنش پایین میآید و سرعت واقعی خودش را نشان میدهد. آنوقت اگر هنوز گلوگاهی باقی مانده باشد، حداقل دارید جای درست را درمان میکنید.
When bottlenecks come up, many managers have a predictable first reaction: measure the time spent in every stage. Find out which person, team, or approval takes the longest. That is not useless, but it often leads us to the easiest answer rather than the right one.
A stage may genuinely take a long time and still deliver usable output every time. Meanwhile, a stage that appears fast can cripple the entire flow because its output is incomplete, unclear, or inconsistent, sending work back for correction. A stopwatch rarely captures that back-and-forth well.
A bottleneck is not only where work stops. Sometimes it is where work passes through, but does not pass through properly. Hours or days later, it returns because of a question, a defect, an incomplete file, or an undecided issue. That is the cost that disappears in stage-time reports.
In sales, operations, content production, customer service, or project delivery, this pattern appears often. One team says the information is insufficient. The previous team says the request was unclear. A manager steps in to resolve an exception. The work is revised and moves forward again. On paper, everyone is busy; in reality, the organization is doing the same work several times.
The problem is that rework is rarely recorded under its real name. It becomes “coordination,” “review,” “a minor revision,” “follow-up,” or “just one quick question.” Each label seems harmless on its own. Put them together, though, and you see that a meaningful share of the team’s capacity is not creating new output; it is repairing earlier output.
To see this problem, you do not need to begin with a complex dashboard, new software, or a data-analysis project. Choose one recurring workflow: one that regularly passes through several people or teams, and whose result matters to customers, revenue, quality, or delivery. The more repeatable the flow, the clearer the signals will be.
For example, choose the path from a customer request to a proposal, from order entry to delivery, or from task definition to final approval. You do not need to dissect the entire business at once. Choosing one bounded flow makes reality easier to see and makes pointless meetings less likely.
Then identify the handoff points. Do not just list department names; identify the moment when a person or team says, “My part is finished; now it is yours.” That moment must be visible. A form, ticket, file, logged message, or defined status in a work tool can be enough. For process management, a verbal handoff is not reliable memory.
For every item that crosses a handoff point, add just one question: was it accepted without a material change, or was it returned? If it was returned, where did it go back to, and what reason was given? The purpose here is not to put people on trial. It is to see the real path of work, not the path drawn in a flowchart.
Keep the record simple. The work item, handoff point, acceptance or return, reason for return, and the decision owner for the next step are usually enough. If the form is so detailed that nobody completes it, you have no data. If it is so vague that everything falls under “mistake,” you still learn nothing.
From the start, group the reasons for returns. Missing information, unclear criteria, execution errors, changed requests, missing decision authority, noncompliance with a standard, and off-path exceptions are useful initial categories. Your categories do not need to be perfect. They need to be clear enough that two people would place a similar event in roughly the same group.
You will quickly notice that not all returns have the same value. Some are natural, such as when a customer truly changes a request. Others reveal weak process design, such as when the next team must ask for the same basic information again or when every output moves back and forth between two people several times before approval.
This is where the key question changes. Instead of asking, “Who is slow?” ask, “What was missing from this output at the first handoff that made it unacceptable?” The question sounds simple, but it moves the conversation from individual blame to system improvement.
The answer is often found in the lack of a definition for “ready to hand off.” Many teams do not have a precise definition of what finished work means. Everyone considers the work done based on their own interpretation. One person says a file is ready because it has been prepared; another says it is not ready because a source, approval, or required information is missing. Both may be right from their own perspective.
A ready-for-handoff criterion does not need to be a heavy document full of legal-style clauses. A few clear conditions for each handoff are enough: what information must accompany the work, what decision must already be made, what must not remain unresolved, and who is allowed to accept an exception. A good criterion does not stop conversation; it stops guessing.
If an output keeps coming back, resist the urge to immediately add another person to the team, schedule more coordination meetings, or buy a new tool. These may sometimes be necessary, but they often only create more capacity to carry the same confusion. First, understand where the return loop closes and why it is triggered again and again.
Look at exceptions separately. A process that advances through many exceptions is not really a standard process; it is a collection of case-by-case decisions wearing the clothes of a process. If an exception repeats, it is no longer an exception. It should become a formal path, have its cause removed, or be deliberately stopped.
This perspective matters even more for automation and artificial intelligence. Recent discussions about organizational productivity keep circling back to the same point: adding a smart tool to an already messy workflow usually does not resolve the mess, it just speeds it up. When inputs are unclear, acceptance criteria are undefined, and work repeatedly returns, automation merely increases the speed of producing outputs that need correction. A tool may move work faster, but it cannot create agreement on what “acceptable output” means by itself.
Before automating any part, examine how often work returns at that point and why. If the cause is missing data or the absence of a decision rule, solve that first. If the cause is clear, repetitive work, then automation can help. The order of those two things is the difference between building leverage and building faster disorder.
After a few weeks of observation, do not look for a magic number. Look for patterns: which handoff has the most returns, which reason repeats, who has to absorb the most ambiguity, and which decision keeps being escalated to the manager. These usually offer a truer picture of the bottleneck than average task duration does.
Then choose just one loop and close it. Clarify the handoff criterion, delegate one decision to the right level, place needed information earlier in the flow, or define a path for a recurring exception. Do not attack every problem at once. Processes improve through small, observable changes, not through large plans that are soon forgotten.
Managing a bottleneck is not about hunting for one person to blame. The real work is reducing how often an output must travel backward before it becomes usable. When return loops decrease, time is released, tension drops, and real speed becomes visible. Then, if a bottleneck still remains, at least you are fixing the right place.
اگر این موضوع شبیه مسئله واقعی کسبوکار توست، از چکاپ تصمیم شروع کن.
یک مسیر کوتاه برای روشنکردن مسئله، گلوگاه تصمیم و قدم بعدی؛ بدون فرم طولانی و بدون تعهد.