سنتز خودکار مواد با فرضیهآزمایی عاملهای چندرسانهای
SynAgent، یک سامانه عامل هوشمند چندرسانهای، در آزمایشگاه خودکار فیزیکی ابزار تحلیل ساخت و با آزمون فعال فرضیهها پنجره رشد مطلوب فیلمهای LiCoO₂ را شناسایی کرد.
فهرست مطالب
این مرور بر پیشچاپ arXiv، نسخه ۱ مقاله در ۱۶ سپتامبر ۲۰۲۶، تکیه دارد؛ بنابراین وضعیت داوری مستقل آن در متن منبع تأیید نشده است. مقاله سامانهای به نام SynAgent معرفی میکند که عاملهای چندرسانهای مبتنی بر مدل زبانی بزرگ را به یک آزمایشگاه خودکار متصل میسازد. هدف عامل فقط یافتن نمونه مطلوب نیست، بلکه باید از هر آزمایش، فهمی صریح، قابلردگیری و بازبینیپذیر از ارتباط شرایط سنتز و نتیجه بسازد. آزمون سامانه بر لایهنازک LiCoO₂ با جهتگیری (001) انجام شد.
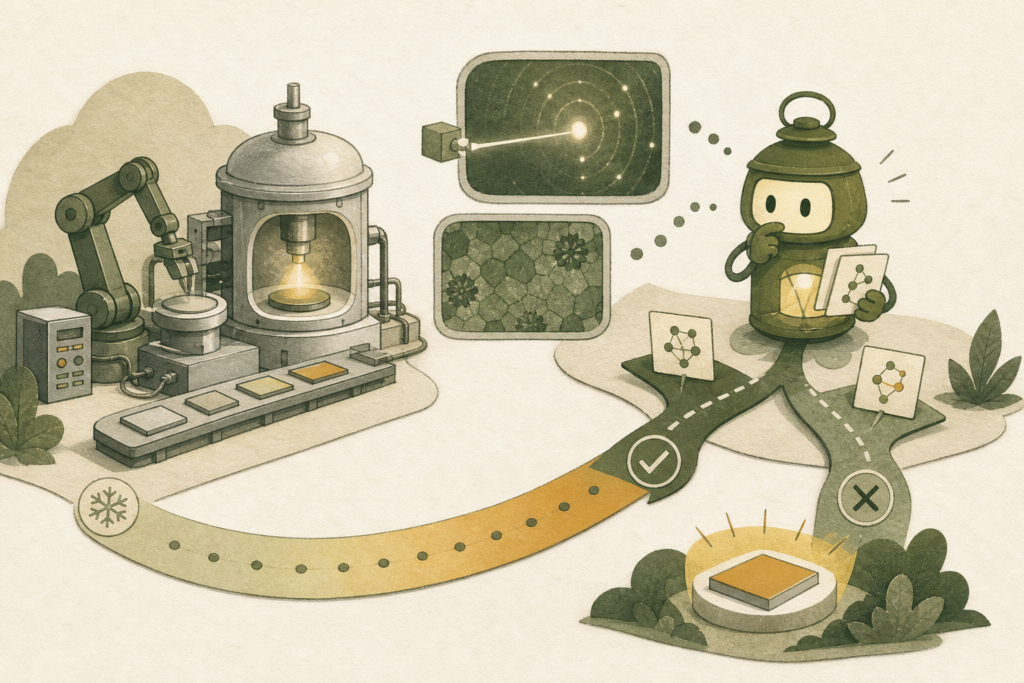
چرخه SynAgent چهار گام دارد: پیشنهاد شرایط بر پایه فهم فعلی، اجرای خودکار سنتز و اندازهگیری، تحلیل دادهها، و بازنویسی فهم پس از مشاهده نتیجه. فهم عامل سندی به زبان طبیعی است که ادعاهای فرایندی را ثبت میکند. در هر تکرار، عامل یا آزمایشی برای تأیید یک ادعا پیشنهاد میدهد یا عمداً شرایطی را میآزماید که انتظار دارد فرضیه در آن شکست بخورد. پیش از اجرا، فرضیه، دمای پیشنهادی و پیشبینی عددی ثبت میشوند؛ سپس نتیجه با دسته موفقیت یا شکست پیشبینیشده سنجیده میشود.
ویژگی دیگر سامانه، تولید تطبیقی «مهارت» تحلیل است. کتابخانه مهارتها در آغاز خالی بود و عامل اصلی، در صورت نیاز، ساخت کد تحلیل را به عامل فرعی واگذار میکرد. در نخستین آزمایش، مهارتی برای یافتن قلههای 003 و 006 در الگوی پراش پرتو ایکس و محاسبه نسبت شدت I(003)/I(006) ساخته شد؛ این نسبت هدف بهینهسازی و سنجه بلورینگی بود. عامل سپس با مشاهده ذرات روشن در تصویر میکروسکوپ الکترونی روبشی، مهارتی برای کمّیسازی ذرات و بافت زمینه تولید کرد.
در کارزار ۱۸ آزمایشی، دمای زیرلایه تنها متغیر کنترلپذیر بود و از ۲۰۰ تا ۷۵۰ درجه سلسیوس، با گامهای ۱۰ درجه، انتخاب میشد؛ توان RF، زمان لایهنشانی و فشارهای گاز ثابت ماندند. عامل از GPT-5.5 استفاده کرد و حالتهای تأیید و ابطال را، با آغاز از تأیید، یکیدرمیان اجرا کرد. از ۱۸ پیشبینی، ۱۵ مورد پشتیبانی و ۳ مورد رد شدند. فیلمهای ۲۵۰ تا ۶۳۰ درجه نسبت کمتر از ۰٫۱ داشتند؛ رشد منظم در ۶۵۰ درجه ظاهر شد و بیشترین نسبت، ۶۱٫۶، در ۶۷۰ درجه به دست آمد.
پیشنهادهای ابطال در تغییر فهم عامل نقش محوری داشتند. در تکرار نخست، پیشبینی موفقیت در ۶۰۰ درجه با نسبت اندازهگیریشده ۰٫۰۰۱ رد شد. سپس عامل در ۷۰۰ درجه شکست را پیشبینی کرد، اما نسبت ۳۵٫۶ اندازهگیری شد و برداشت اولیه از تخریب یکنواخت در دمای بالا کنار رفت. در تکرار دهم نیز برای ۶۵۰ درجه نسبت ۰٫۲ پیشبینی شد، ولی مقدار ۵۴٫۹ مشاهده شد. نقشه نهایی شامل نبود نظم زیر ۶۳۰، گذار ۶۳۰ تا ۶۵۰، پنجره منظم ۶۵۰ تا ۶۹۰، و ناحیه منظم اما زیرِبهینه ۷۰۰ تا ۷۵۰ درجه بود.
محدودیتها مهماند: نمایش مقاله تنها یک ماده و یک متغیر کنترلپذیر را پوشش میدهد و هر دما فقط یک بار آزموده شد؛ پس تفاوتهای کوچک در بازه ۶۵۰ تا ۶۹۰ درجه ممکن است در تغییرپذیری اجرای آزمایش باشند. مقایسه کنترلشده با بهینهسازی بیزی، با بودجه آزمایشی برابر، انجام نشد. مهارتها فقط با خودآزمونهای سامانه اعتبارسنجی شدند و داوری پشتیبانی یا رد پیشبینیها بر استدلال مدل تکیه داشت. همچنین SEM بهتنهایی ترکیب یا هویت فازی ذرات را تعیین نمیکند؛ مقاله مشخصهیابی بیشتر و آزمون ۶۴۰ درجه را پیشنهاد میکند.
This review is based on the arXiv preprint, version 1 of the paper dated 16 September 2026; its independent peer-review status is therefore not confirmed in the source text. The paper presents SynAgent, which connects multimodal large-language-model agents to an automated laboratory. The agent’s goal is not only to find a desirable sample, but also to construct an explicit, traceable, and revisable understanding of the relationship between synthesis conditions and outcomes from each experiment. The system was tested on (001)-oriented LiCoO₂ thin films.
SynAgent follows four steps: proposing conditions from its current understanding, autonomously conducting synthesis and measurement, analyzing the data, and rewriting the understanding after observing the outcome. The agent’s understanding is a natural-language document that records process claims. In each iteration, it either proposes an experiment to verify a claim or deliberately tests conditions where the hypothesis is expected to fail. Before execution, the hypothesis, proposed temperature, and numerical prediction are recorded; afterward, the result is assessed against the predicted success or failure category.
Another system feature is adaptive generation of analysis “skills.” The skill library was initially empty, and the main agent delegated analysis-code creation to a subagent when needed. In the first experiment, it created a skill to locate the 003 and 006 peaks in an X-ray diffraction pattern and calculate I(003)/I(006), the optimization target and crystallinity measure. After observing bright particles in a scanning electron microscopy image, the agent created a skill to quantify particles and background texture.
In the 18-experiment campaign, substrate temperature was the only controllable variable, selected from 200 to 750 °C in 10 °C increments; RF power, deposition time, and gas pressures remained fixed. The agent used GPT-5.5 and alternated verify and falsify modes, starting with verification. Of the 18 predictions, 15 were supported and 3 were refuted. Films at 250–630 °C had ratios below 0.1; ordered growth appeared at 650 °C, and the largest ratio, 61.6, was obtained at 670 °C.
Falsify proposals played a central role in changing the agent’s understanding. In the first iteration, a predicted success at 600 °C was refuted by a measured ratio of 0.001. The agent then predicted failure at 700 °C, but measured 35.6, overturning its initial view of uniform high-temperature degradation. In iteration 10, it predicted 0.2 at 650 °C, yet observed 54.9. The final map included no ordering below 630 °C, a 630–650 °C transition, a 650–690 °C ordered window, and an ordered but suboptimal 700–750 °C region.
The limitations are important: the demonstration covers only one material and one controllable variable, and each temperature was tested once; thus, small differences within 650–690 °C may reflect run-to-run variation. No controlled comparison with Bayesian optimization under matched experimental budgets was performed. Skills were validated only through system self-tests, and judgments that predictions were supported or refuted relied on the model’s reasoning. SEM alone also cannot establish particle composition or phase identity; the paper proposes further characterization and a 640 °C experiment.
پژوهشهای بیشتری بخوان
مقالات بیشتر درباره هوش مصنوعی و پژوهشهای تازه را ببین.