Sphere Encoder 2: تولید تصویر با چرخش در فضای نهفته کروی
این مقاله نسخه دوم Sphere Encoder را معرفی میکند: یک خودرمزگذار تکمرحلهای برای تولید تصویر که با پوششدادن ناحیه استوایی کره نهفته و جداکردن بازسازی از تولید، کیفیت نمونههای ImageNet را بهبود میدهد.
فهرست مطالب
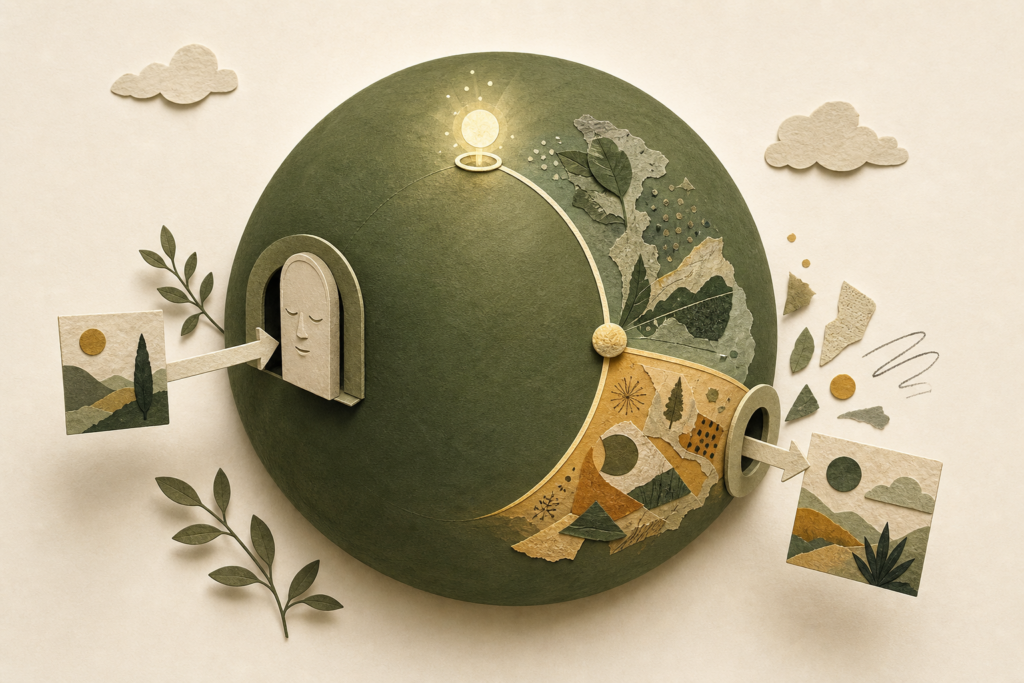
این معرفی بر نسخه پیشچاپ موجود در arXiv، یعنی arXiv:2610.02208v1 در ۱ اکتبر ۲۰۲۶، تکیه دارد و وضعیت داوری همتای مستقل آن تأیید نشده است. Sphere Encoder 2 یک خودرمزگذار غیرتغییریافته برای تولید تصویر است: رمزگذار تصویر را به برداری روی یک کره با بُعد بالا میبرد و رمزگشا از آن تصویر میسازد. ایده اصلی این است که بتوان یک نقطه تصادفی روی کره را مستقیماً، حتی در یک گام، به پیکسل تبدیل کرد؛ برخلاف تولیدهای چندگامهای مانند مدلهای انتشار.
مقاله دو مشکل در Sphere Encoder اولیه مطرح میکند. نخست، نویز آموزشی فقط تا زاویه ۸۵ درجه به بردار نهفته افزوده میشد، در حالی که در ابعاد بالا نمونههای تصادفی کره نزدیک استوا قرار میگیرند؛ پس یک شکاف ۵ درجهای تا ناحیهای باقی میماند که در تولید یکگامه دیده میشود. Sphere Encoder 2 بهجای افزودن نویز و تصویرکردن دوباره، بردار را با ترکیب cos(α)z و sin(α)F(e) صریحاً میچرخاند. در نتیجه α از صفر تا ۹۰ درجه تعریف میشود و نقطه ۹۰ درجه همان جهت تصادفی مورد استفاده برای تولید است.
مشکل دوم، استفاده از زیان بازسازی پیکسلی در سراسر مسیر چرخش بود که میتواند میانگین تصاویر محتمل را ترجیح دهد و خروجی را تار کند. روش جدید مسیر را در زاویه قطع پیشفرض ۷۰ درجه به دو بخش تقسیم میکند. در زوایای پایین، ترکیب LPIPS و L1 برای بازسازی حفظ میشود. در زوایای بالاتر، زیان پیکسلی کنار گذاشته میشود و همترازی معناییِ لاجیتهای ConvNeXt، سازگاری نهفته، و یک زیان تطبیق امتیاز به کار میرود. گذار میان دو بخش با تابع سیگموید و پهنای پیشفرض ۵ درجه وزندهی میشود.
برای زیان تطبیق امتیاز، ویژگیهای تصاویر واقعی و تولیدی از یک استخراجگر منجمد ConvNeXt V2-N گرفته میشود. سپس دو مدل امتیازدهی کوچکِ دو-لایه، یکی برای ویژگیهای واقعی و دیگری برای ویژگیهای تولیدی، همزمان آموزش میبینند. اختلاف خروجی آنها جهت بهروزرسانی رمزگشا را فراهم میکند تا ویژگی تولیدی به توزیع واقعی نزدیک شود؛ خود مدلهای امتیاز هنگام این انتقال منجمد هستند. نویسندگان این سازوکار را جایگزینی بدون آموزش خصمانه و بدون معلم انتشار ازپیشآموزشدیده معرفی میکنند، نه اثباتی برای برتری عمومی آن در همه تنظیمات.
در پیکربندی گزارششده، رمزگذار DINOv3-small منجمد است و فقط رمزگشای ViT در اندازههای Base و Large آموزش میبیند. روی ImageNet، Sphere2-L بدون CFG و با ۴ ارزیابی شبکه، FDr6 برابر ۵٫۷۷ در ۲۵۶×۲۵۶ و ۶٫۳۵ در ۵۱۲×۵۱۲ گزارش میکند؛ نسخه دارای FD-lite بهترتیب ۵٫۱۴ و ۶٫۶۰ دارد. Sphere2-B در ۲۵۶×۲۵۶ با یک گام FDr6 برابر ۱۴٫۵۳ ثبت کرده است. مقاله همچنین برای Sphere2-L در ۵۱۲×۵۱۲ و دسته ۱۶، زمان تولید ۵۰هزار تصویر را ۲ دقیقه برای یک گام بدون راهنمایی و ۱۴ دقیقه برای چهار گام با CFG گزارش میکند. اینها نتایج همان آزمایشها و معیارهای مقالهاند.
محدودیتها مهماند: کیفیت با FDr6 بهتر از gFID گزارش شده و نویسندگان این اختلاف را به فضای ویژگی ConvNeXt در زیان امتیاز و جابهجایی آماری در فضای قدیمی Inception نسبت میدهند. FD-lite این مسئله را در بسیاری از حالتها کاهش میدهد، اما برای Sphere2-L یکگامه FDr6 را بدتر میکند. ارزیابیها روی Oxford Flowers و ImageNet، با تولید شرطی بر کلاس، انجام شدهاند؛ مقاله آزمونی برای متنبهتصویر، دادههای دیگر، یا ترجیح انسانی ارائه نمیکند. همچنین خروجیهای بازسازی در رژیم کمزاویه عمداً بدون تیزسازی خصمانهاند و ممکن است بافتی نرم یا «waffle-like» داشته باشند.
This overview is based on the available arXiv preprint, arXiv:2610.02208v1 dated October 1, 2026, and this section does not independently confirm its peer-review status. Sphere Encoder 2 is a non-variational autoencoder for image generation: an encoder maps an image to a vector on a high-dimensional sphere, and a decoder maps that vector back to an image. The central goal is to decode a random spherical point directly into pixels, even in one step, rather than relying on a many-step process such as diffusion.
The paper identifies two issues in the original Sphere Encoder. First, training noise reached only 85 degrees, while random points on a high-dimensional sphere concentrate near the equator; this leaves a five-degree gap before the region used in one-step generation. Sphere Encoder 2 replaces additive noise plus reprojection with an explicit rotation, combining cos(α)z and sin(α)F(e). Thus, α is defined from zero to 90 degrees, and the 90-degree endpoint is exactly the random direction used for generation.
The second issue is applying pixel-wise reconstruction loss along the whole rotation path, which can favor averages of plausible images and produce blur. The new method splits the path at a default cutoff of 70 degrees. At low angles, it retains a combination of LPIPS and L1 reconstruction losses. At higher angles, it removes pixel loss and uses semantic alignment of ConvNeXt logits, latent consistency, and a score-matching loss. A sigmoid with default bandwidth of five degrees weights the transition between the two regimes.
For score matching, features of real and generated images are extracted by a frozen ConvNeXt V2-N network. Two small two-layer score models are then trained online, one on real features and one on generated features. The difference between their outputs provides an update direction for the decoder so generated features move toward the real distribution; the score models themselves are frozen during this transport. The authors present this as an alternative that does not require adversarial training or a pretrained diffusion teacher, not as evidence of universal superiority across settings.
In the reported configuration, DINOv3-small is a frozen encoder, while only a Base or Large ViT decoder is trained. On ImageNet, Sphere2-L without CFG and with four network evaluations reports FDr6 of 5.77 at 256×256 and 6.35 at 512×512; the FD-lite variant reports 5.14 and 6.60, respectively. Sphere2-B reports FDr6 of 14.53 with one step at 256×256. For Sphere2-L at 512×512 and batch size 16, the paper also reports two minutes to generate 50,000 images in one unguided step and 14 minutes in four CFG steps. These are results from the paper’s own experiments and metrics.
The limitations matter. Quality is reported as stronger under FDr6 than under gFID, and the authors attribute this gap to the ConvNeXt feature space used by the score loss and a statistical shift in the older Inception space. FD-lite reduces this issue in many cases, but worsens one-step FDr6 for Sphere2-L. Evaluations use class-conditional Oxford Flowers and ImageNet; the paper does not test text-to-image generation, other datasets, or human preference. Low-angle reconstructions also intentionally omit adversarial sharpening and may retain soft or "waffle-like" textures.
پژوهشهای بیشتری بخوان
مقالات بیشتر درباره هوش مصنوعی و پژوهشهای تازه را ببین.