تراز بینزبانی در مدلهای MoE با خروجی مسیریابها
این مقاله روشی برای همراستا کردن پردازش زبانهای مختلف در مدلهای decoder-only مبتنی بر MoE معرفی میکند: نزدیککردن توزیع میانگینِ انتخاب متخصصان برای جملههای ترجمهشده. آزمایشها روی چهار مدل و هفت زبان، بهبود میانگین تا ۲٫۱ امتیاز نسبت به CPT پایه را گزارش میکنند؛ داوری مستقل این نسخه هنوز تأیید نشده است.
فهرست مطالب
این معرفی بر نسخه پیشچاپ موجود در arXiv، یعنی arXiv:2610.01921v1 مورخ ۱ اکتبر ۲۰۲۶، تکیه دارد. در متن مقاله اشارهای به داوری همتا یا پذیرش قطعی نشده و وضعیت داوری مستقل آن در اینجا تأیید نشده است. مقاله مسئله تراز بازنماییهای بینزبانی در مدلهای زبانی بزرگ decoder-only را بررسی میکند. در این مدلها، تفاوت توکنسازی و نبودِ یک بازنمایی طبیعی در سطح دنباله، مقایسه مستقیم جملههای ترجمهشده را دشوار میکند. نویسندگان پیشنهاد میکنند بهجای همراستا کردن مستقیم حالتهای پنهان، خروجی مسیریابها در معماری mixture-of-experts یا MoE هدف تراز قرار گیرد.
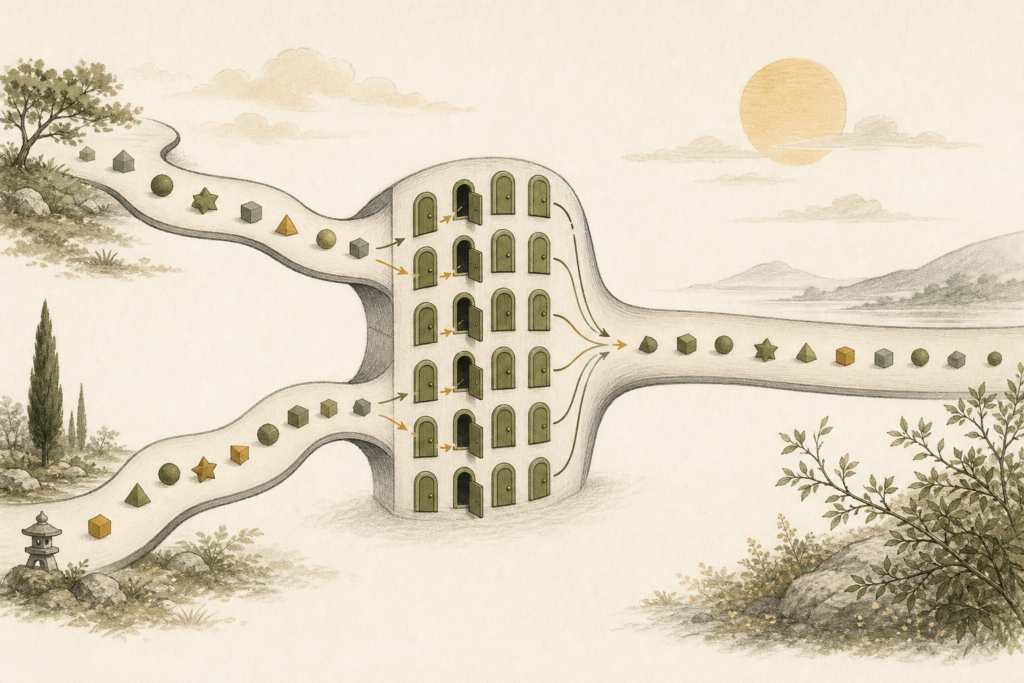
در MoE، مسیریاب برای هر توکن توزیعی روی متخصصان تولید میکند و تنها بخشی از آنها فعال میشوند. روش پیشنهادی ابتدا وزنهای مسیریابی همه توکنهای یک دنباله انگلیسی و ترجمه آن را میانگین میگیرد. سپس واگرایی KL میان این دو توزیع در لایههای میانی منتخب محاسبه و با زیان مدلسازی زبان جمع میشود. گرادیان فقط از مسیر دنباله زبان مقصد عبور میکند؛ دنباله انگلیسی صرفاً مرجع محاسبه توزیع مسیریابی است. انتخاب لایهها نیز بر پایه منحنی واگرایی مسیریابی میان زبانها انجام شده است.
آزمایشها یک مرحله پیشآموزش پیوسته کوتاه، شامل یک گذر روی ۲۰۰ هزار نمونه موازی انگلیسی–زبان مقصد، برای هر زبان اجرا میکنند؛ هزار نمونه نیز برای اعتبارسنجی کنار گذاشته شده است. چهار مدل Qwen3-30B-A3B، GPT-OSS-20B، Granite-4.0-H-Tiny و Marco-Nano بررسی شدهاند. زبانهای مقصد ویتنامی، سینهالی، مجاری، تلوگو، کانادا، تایلندی و قرقیزیاند. دادهها از متنهای همتراز جملهای و گفتوگوهای دستور–پاسخ موازی ساخته شدهاند و ارزیابی فقط به زبانهایی محدود شده که مدل پایه در آنها توانایی غیر بدیهی داشته است.
نویسندگان برای کاهش هزینه، دنبالههای مبدأ و مقصد را بدون padding در یک عبور مشترک بستهبندی میکنند؛ توکنهای انگلیسی پس از آخرین لایه تراز از محاسبه خارج میشوند. در سنجش درونی روی داده FLORES خارج از توزیع آموزش، زیان کمکی در همه مدلها و زبانها بیشترین کاهش واگرایی مسیریابی نسبت به مدل پایه یا CPT معمولی را ایجاد کرده است. سنجه SoftCKA نیز، در گزارش Qwen3، افزایش شباهت حالتهای پنهان با انگلیسی را پس از آموزش نشان میدهد؛ بنابراین اثر گزارششده صرفاً محدود به خروجی مسیریاب نیست.
ارزیابی پاییندستی مجموعهای متنوع از تولید، درک، دانش، استدلال فیزیکی و ریاضی را پوشش میدهد؛ از جمله FLORES، Belebele، Global-MMLU، MMLU-ProX، MultiLoKo، INCLUDE، Global-PIQA، MGSM و PolyMath. میانگین امتیازهای در دسترس برای ۱۳ مورد از ۱۴ جفت مدل–زبان نسبت به CPT پایه بهتر و برای یک مورد، Marco-Nano در ویتنامی، برابر بوده است. بیشترین بهبود میانگین ۲٫۱ و میانگین بهبود همه جفتها ۰٫۹ امتیاز گزارش شده است. در مقایسه محدود Marco-Nano، زیان مسیریابی برای سینهالی ۲۶٫۸ در برابر ۲۶٫۳ و برای مجاری ۳۸٫۱ در برابر ۳۶٫۹ِ زیان تراز حالت پنهان به دست آورد.
محدودیتها مهماند. آزمایشها کوتاه و روی مدلهای پسآموزشدیده انجام شدهاند؛ CPT در این وضعیت حساس است و خودِ خط پایه نیز معمولاً فقط بهبودهای محدود میگیرد. روش کاملاً به داده موازی وابسته است، در حالی که بخش بزرگی از دادههای آموزش موازی نیست و پیکرههای موجود عمدتاً جملهایاند. نویسندگان جفت منفی یا تعامل زیان پیشنهادی با زیان توازنبار MoE را بررسی نکردهاند. مقایسه با تراز حالت پنهان تنها دو زبان و یک مدل را پوشش میدهد، و نتایج نشان نمیدهد کدام نوع وظیفه بیش از دیگران سود میبرد. اثر در مقیاس پیشآموزش نیز در مقاله آزموده نشده است.
This introduction relies on the preprint version available on arXiv, arXiv:2610.01921v1 dated October 1, 2026. The paper text makes no mention of peer review or formal acceptance, and its independent peer-review status is unconfirmed here. The paper studies cross-lingual representation alignment in decoder-only large language models. In these models, differences in tokenization and the absence of a natural sequence-level representation make direct comparison of translated sentences difficult. The authors propose aligning router outputs in mixture-of-experts (MoE) architectures rather than directly aligning hidden states.
In an MoE, a router produces a distribution over experts for each token, while only a subset is activated. The proposed method first averages routing weights across all tokens in an English sequence and its translation. It then computes KL divergence between these distributions in selected middle layers and adds it to the language-modeling loss. Gradients pass only through the target-language sequence; the English sequence is used solely as a routing-distribution reference. Layers are selected using cross-language routing-divergence curves.
The experiments run a short continual-pretraining stage, consisting of one pass over 200,000 parallel English–target-language samples for each language; 1,000 examples are reserved for validation. They examine Qwen3-30B-A3B, GPT-OSS-20B, Granite-4.0-H-Tiny, and Marco-Nano. Target languages are Vietnamese, Sinhala, Hungarian, Telugu, Kannada, Thai, and Kyrgyz. Data are constructed from sentence-aligned text and parallel instruction–response conversations, and evaluation is limited to languages where the base model already has non-trivial capability.
To reduce cost, the authors pack source and target sequences into a shared pass without padding; English tokens exit computation after the final alignment layer. On FLORES data that are out of distribution relative to training, the auxiliary loss produced the largest routing-divergence reduction relative to the base model or standard CPT for all models and languages. SoftCKA, reported for Qwen3, also shows increased hidden-state similarity to English after training; the reported effect is therefore not limited to router outputs.
Downstream evaluation covers generation, understanding, knowledge, physical reasoning, and mathematical reasoning, including FLORES, Belebele, Global-MMLU, MMLU-ProX, MultiLoKo, INCLUDE, Global-PIQA, MGSM, and PolyMath. Average scores over available tasks improved over baseline CPT in 13 of 14 model–language pairs and tied in one case, Marco-Nano for Vietnamese. The largest average gain was 2.1 points, while the mean gain across all pairs was 0.9 points. In the limited Marco-Nano comparison, routing loss obtained 26.8 versus 26.3 for hidden-state alignment in Sinhala, and 38.1 versus 36.9 in Hungarian.
The limitations are important. Experiments are short and use post-trained models; CPT is sensitive in this setting, and the baseline itself generally gains only modestly. The method depends entirely on parallel data, whereas much training data are not parallel and available corpora are mainly sentence-level. The authors did not test negative pairs or the interaction between the proposed loss and MoE load balancing. The hidden-state alignment comparison covers only two languages and one model, and results do not establish which task types benefit more. Pretraining-scale effects were not tested.
پژوهشهای بیشتری بخوان
مقالات بیشتر درباره هوش مصنوعی و پژوهشهای تازه را ببین.