تفکیک خطاهای استدلال فضایی و عملگرهای ترکیبپذیر برای ویدیو
این مقاله CROSS را معرفی میکند: کتابخانهای بدون آموزش افزوده برای اجرای محاسبات هندسی صریح در استدلال فضایی ویدیویی. نویسندگان با تفکیک ادراک، کفایت شواهد، انتخاب اندازهگیری و قراردادهای چارچوب مختصات، گزارش میکنند که این روش در چند بنچمارک امتیازها را بهبود میدهد؛ با این حال، محدودیتهای بازسازی، پوشش عملگرها و مقایسههای بینسامانهای باقی میماند.
فهرست مطالب
این معرفی بر نسخه پیشچاپ (preprint) موجود در arXiv:2610.01999v1، منتشرشده در ۱ اکتبر ۲۰۲۶، تکیه دارد؛ در متن مقاله یا این معرفی هیچ اشارهای به داوری همتا (peer review) وجود ندارد و وضعیت داوری مستقل آن تأیید یا رد نشده است. مقاله میپرسد چرا مدلهای بیناییـزبانی در پرسشهای فضایی ویدیویی خطا میکنند؛ زیرا امتیاز نهایی یک بنچمارک بهتنهایی روشن نمیکند مشکل از دیدن صحنه است یا از محاسبه و تفسیر روابط فضایی. دامنه کار شامل وظایفی مانند فاصله، جهت نسبی، برنامهریزی مسیر، برآورد ژست دوربین و اندازهگیری در ویدیوهای ایستا و پویا است.
نویسندگان برای تفکیک علتها، پاسخگویی با ویدیو را با پاسخگویی همراه با «زمینه فضایی ساختیافته» مقایسه میکنند. این زمینه، قرارداد مختصات، ابعاد کلی صحنه، مشاهدههای سهبعدی اشیا و مسیر زماندار دوربین را در یک قالب مشترک نگه میدارد. دو گونه زمینه به کار میرود: زمینه پیشبینیشده از ماسکها، رهگیریها، هندسه عمقی و ژست دوربین؛ و زمینه حقیقتمبنا از برچسبهای منبع. تفاوت این دو، جریمه ادراک را نشان میدهد و خطاهای باقیمانده با زمینه معتبر حقیقتمبنا، «باقیمانده استدلال» تلقی میشوند.
تشخیص کنترلشده چهار منشأ تکرارشونده خطا را گزارش میکند: ادراک نادقیق؛ نبود اطلاعات لازم در زمینه؛ انتخاب کمیت نادرست؛ و خطا در چارچوب مرجع یا وضعیت زمانیـمکانی. برای نمونه، مدل ممکن است فاصله مرکز تا مرکز دو شیء را به جای کمترین فاصله بین سطوح گزارش کند، یا چپ و راست را با محورهای صحنه به جای دید ناظر تعیین کند. در هشت زیرکار، ۵۲٫۵ تا ۹۹٫۱ درصد شکستهای دارای زمینه حقیقتمبنا با قواعد تشخیصی مقاله با یکی از این الگوها سازگار بودهاند؛ این سازگاری علت یگانه هر خطا را اثبات نمیکند.
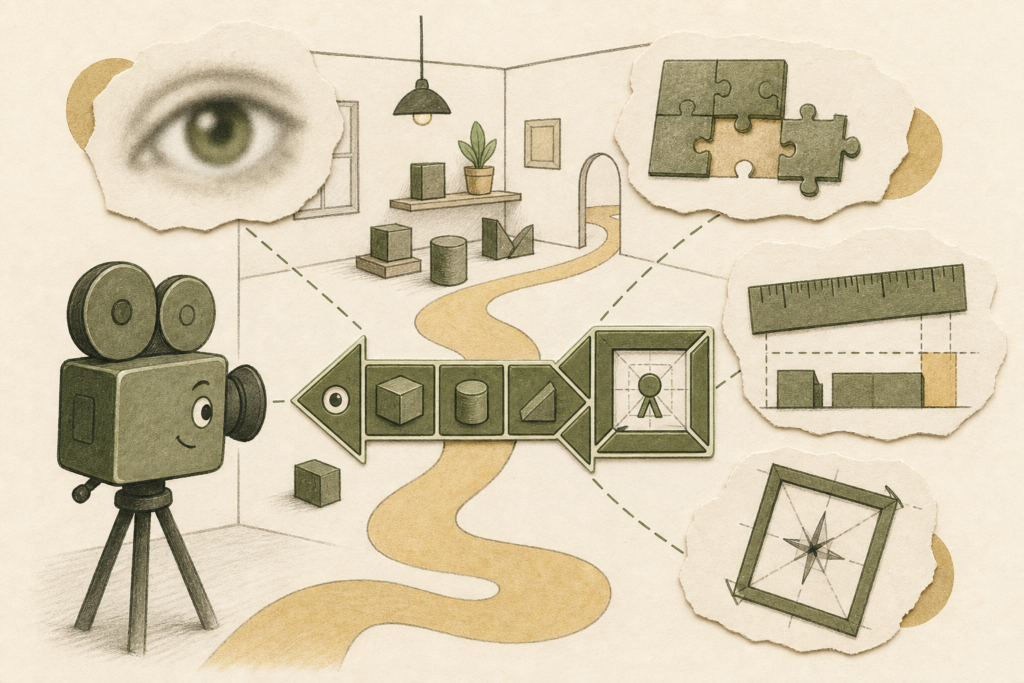
راهحل پیشنهادی، CROSS، کتابخانهای بدون آموزش افزوده از عملگرهای هندسی نوعدار و مهارتهای فضایی ترکیبپذیر است. خانواده عملگرها چارچوب مختصات، هندسه/شکل، انتخاب و تصمیم، و زمان/وضعیت را پوشش میدهند. مهارت فاصله سطحی، هندسه اشیا را گردآوری و شکاف نزدیکترین مرزها را اندازه میگیرد؛ مهارت جهت نسبی، دستگاه ناظر را میسازد و هدف را در آن تصویر میکند؛ و مهارت مسیر، موقعیت و جهت حرکت را پس از هر گام بهروزرسانی میکند. سازوکار دروازهبان فقط خروجی معتبر را به مدل میافزاید و در غیر این صورت به استدلال صرفاً ویدیویی بازمیگردد.
آزمایش تشخیصی با Qwen3-VL-32B-Thinking در REVSI-TINY با ۸۲۳ پرسش و RESTI-TINY با ۷۷۵ پرسش انجام شد؛ بودجه فریمها بهترتیب ۳۲ و ۳۰ بود. با زمینه پیشبینیشده، CROSS میانگین REVSI-TINY را از ۵۰٫۰ به ۶۰٫۴ درصد و RESTI-TINY را از ۳۴٫۳ به ۴۳٫۹ درصد رساند. در ReVSI با ۶۴ فریم، میانگین استنتاج مستقیم ۵۵٫۹ درصد، زمینه پیشبینیشده ۵۲٫۲ درصد و زمینه همراه CROSS ۶۰٫۲ درصد بود. در رابط عامل کدنویس نیز SpatialClaw در DSI-Bench کامل از ۶۲٫۸ به ۶۶٫۳ درصد رسید، در حالی که عملگرهای پایه ثابت نگه داشته شدند.
محدودیتها مهماند: زمینه پیشبینیشده همچنان به یادآوری اشیای متنباز، مقیاس متریک تکچشمی و رانش چرخشی وابسته است؛ دروازهبان ابتکاری همه خروجیهای نادرست را تشخیص نمیدهد؛ و فرضهای آن درباره مقیاس اتاق شاید به صحنههای بیرونی منتقل نشود. عملگرها شتاب یا ترتیب ظهور را پوشش نمیدهند و زیرمجموعه داخلی RESTI پرسش شتاب نداشت. همچنین عملگرهای قطعی بخشی از پاسخ را از پیش محاسبه میکنند؛ بنابراین نتایج، پایبندی قابلاعتماد به قراردادها را نشان میدهند، نه لزوماً یادگیری الگوریتم فضایی درونی توسط مدل. امتیازهای روشهای منتشرشده نیز، به علت تفاوت مدل پایه و بودجه فریم، مقایسه همسان نیستند و مقاله آزمون معناداری گزارش نمیکند.
This introduction is based on the preprint available as arXiv:2610.01999v1, posted on October 1, 2026; neither the paper nor this summary indicates peer review, and its independent peer-review status is therefore not confirmed. The paper asks why vision-language models fail on video spatial questions, since a benchmark’s final score alone cannot reveal whether the issue is scene perception or the computation and interpretation of spatial relations. Its scope includes distance, relative direction, route planning, camera-pose estimation, and measurement tasks in static and dynamic videos.
To separate causes, the authors compare video-only answering with answering augmented by structured spatial context. This context stores a coordinate contract, global scene dimensions, 3D object observations, and a timestamped camera trajectory in a shared schema. Two versions are used: predicted context from masks, tracks, depth geometry, and camera poses; and ground-truth context from source annotations. Their difference indicates a perception penalty, while remaining failures with valid ground-truth context are treated as a reasoning residual.
The controlled diagnosis reports four recurring error sources: inaccurate perception; missing required information in the context; selection of the wrong quantity; and errors in reference frames or spatial state. For example, a model may report center-to-center distance rather than the closest surface gap, or decide left versus right from scene axes rather than an observer’s viewpoint. Across eight subtasks, 52.5–99.1% of ground-truth-context failures matched one of the paper’s diagnostic rules; this consistency does not establish a unique cause for every error.
The proposed solution, CROSS, is a training-free library of typed geometric operators and composable spatial skills. Its operator families cover coordinate frames, geometry/shape, set and decision operations, and temporal/state operations. A surface-distance skill aggregates object geometry and measures the nearest boundary gap; a relative-direction skill builds an observer frame and projects the target into it; and a route skill updates position and heading after each step. A gate adds only valid derived outputs to the model context and otherwise falls back to video-only reasoning.
Diagnostic experiments used Qwen3-VL-32B-Thinking on REVSI-TINY with 823 questions and RESTI-TINY with 775 questions, using 32 and 30 frames respectively. With predicted context, CROSS raised the REVSI-TINY average from 50.0% to 60.4% and the RESTI-TINY average from 34.3% to 43.9%. On ReVSI with 64 frames, direct inference averaged 55.9%, predicted context 52.2%, and predicted context with CROSS 60.2%. In the code-writing interface, SpatialClaw on the full DSI-Bench rose from 62.8% to 66.3% while the atomic operators were kept frozen.
The limitations are consequential. Predicted context still depends on open-vocabulary object recall, monocular metric scale, and rotational drift; the heuristic gate cannot detect every incorrect output; and its room-scale assumptions may not transfer to outdoor scenes. The operator set does not cover acceleration or appearance order, and the indoor RESTI subset contained no acceleration questions. Deterministic operators also precompute part of an answer, so the results show reliable convention enforcement rather than necessarily an internally learned spatial algorithm. Finally, published-system scores are not matched comparisons because backbones and frame budgets differ, and the paper reports no significance tests.
پژوهشهای بیشتری بخوان
مقالات بیشتر درباره هوش مصنوعی و پژوهشهای تازه را ببین.