مسیرگذاری UTF-8 و UTF-16 برای کاهش شکاف توکن میان خطها
UBE با حفظ هسته BPE، نویسههای سهبایتی UTF-8 را از مسیر UTF-16 عبور میدهد تا نابرابری بودجه توکن میان خطها را کاهش دهد؛ اما کیفیت مدل زبانی عمدتاً نزدیک و آمیخته باقی میماند.
فهرست مطالب
این خلاصه بر پیشچاپ arXiv:2610.01984v1 تکیه دارد که در تاریخ ۱ اکتبر ۲۰۲۶ بارگذاری شده است، یعنی پس از تاریخ جاری این بررسی (۴ اکتبر ۲۰۲۶). مقاله بهصورت ارسالی به NeurIPS 2026 معرفی شده، اما در متن در دسترس هیچ شواهدی از تکمیل داوری همتراز مستقل یافت نشد؛ بنابراین وضعیت داوری آن را باید «تأییدنشده» دانست، نه لزوماً داوریشده و نه جعلی. مقاله نابرابری بودجه توکن در توکنسازهای BPE بایتسطحی مبتنی بر UTF-8 را بررسی میکند: متنهای همارز در خطهای گوناگون میتوانند تعداد توکن بسیار متفاوتی مصرف کنند و در پنجره زمینه ثابت، بر زمینه قابلاستفاده، زمان پردازش پرامپت و هزینه اثر بگذارند.
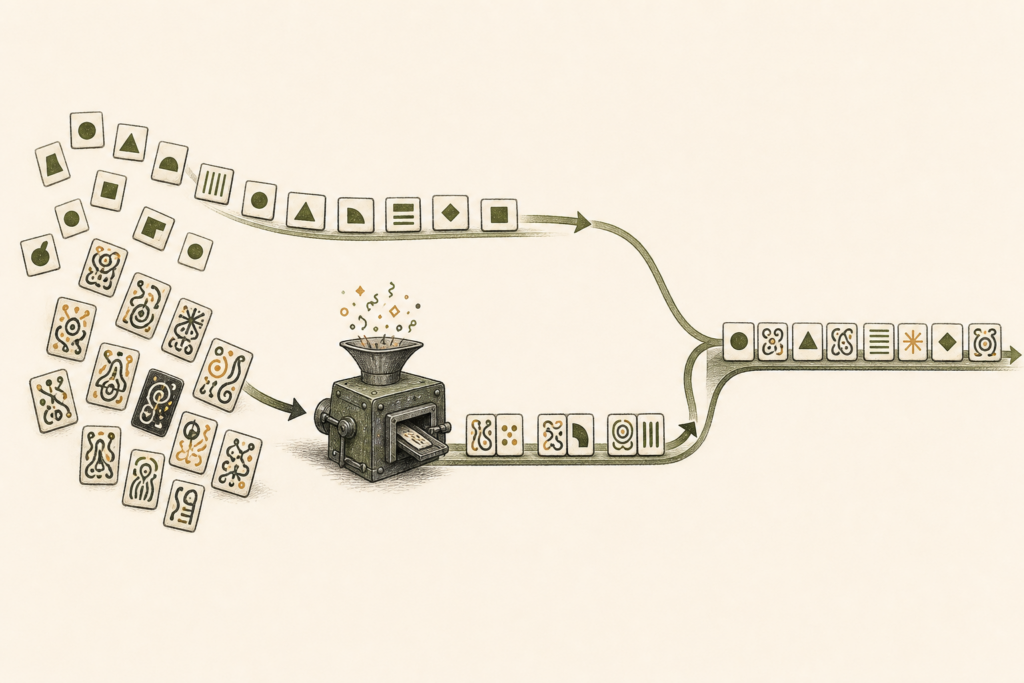
مبنای روش، «کف رمزگذاری» پیش از ادغامهای BPE است، نه تضمین تعداد توکن نهایی. در BBPE استاندارد، کف ASCII یک نماد است؛ بسیاری از نویسههای سیریلیک، عربی و عبری دو نماد دارند؛ و نویسههای CJK، دواناگری و تایلندی سه نماد. روش Universal Byte-Level Encoding یا UBE، هر مقدار اسکالر یونیکد را فقط با توجه به طول UTF-8 مسیرگذاری میکند: نویسههای یک یا دو بایتی در مسیر UTF-8 میمانند و نویسههای سه یا چهاربایتی به UTF-16LE میروند.
در نتیجه، کف نویسههای سهبایتی صفحه پایه چندزبانه از ۳ به ۲ کاهش مییابد، درحالیکه ASCII روی ۱ میماند؛ نویسههای غیر-BMP چهاربایتی همچنان کف ۴ دارند. UBE از دو الفبای مجزای ۲۵۶نمادی، یکی برای UTF-8 و دیگری در بازه استفاده خصوصی یونیکد برای بایتهای UTF-16، استفاده میکند. قواعد ادغام و انتخاب BPE، نبود نیاز به شناسایی زبان یا خط، و معماری ترنسفورمر بدون تغییر میمانند. بهای این طراحی، ۲۵۶ جای ادغام کمتر از BBPE است؛ در واژگان ۳۲هزارتایی حدود ۰٫۸٪ سربار.
در FLORES-200، شامل ۱٬۰۱۲ جمله همتراز در ۲۰۴ پیکربندی زبان-خط، UBE در همه مقایسههای اصلی ۱۶هزار، ۳۲هزار و ۶۴هزار ضریب جینی نسبت تعداد توکن به انگلیسی را کاهش داد؛ کاهش نسبی در نه مقایسه اصلی بین ۶ تا ۱۴٪ بود. در تنظیم اصلی ۱۰۱زبانه با واژگان ۳۲هزارتایی، جینی از ۰٫۲۱۸۳ به ۰٫۱۹۷۹ رسید، یعنی ۹٫۴٪ کاهش، و UBE برای ۱۸۹ زبان از ۲۰۴ زبان توکن کمتری تولید کرد. سانتالی ۳۴٫۷٪ و تمازیغ اطلس مرکزی ۳۱٫۹٪ کاهش توکن داشتند. در واژگان ۲۵۶هزارتایی، کاهش جینی به حدود ۱٫۹٪ محدود شد.
در آزمونهای تکمیلی همان تنظیم ۱۰۱زبانه با واژگان ۳۲هزارتایی، تغییر جینی برای UDHR، SIB-200 و MGSM بهترتیب حدود ۱۱٫۱٪ کاهش، ۸٫۵٪ کاهش و ۰٫۱٪ افزایش بود. نویسندگان بهدلیل همپوشانی متن عمومی، UDHR را آزمون فشار میدانند، نه مجموعهای کاملاً مستقل از داده آموزشی. در مدلهای زبانی ۱۸۲میلیونپارامتری با واژگان ۳۲هزارتایی، نتایج کیفیت کوچک و آمیختهاند: در سه بذر تصادفی مستقل، جینی بیتبربایت عملاً برابر بود: برای BBPE برابر ۰٫۱۸۱۹ بهعلاوه یا منهای ۰٫۰۰۵۲ و برای UBE برابر ۰٫۱۸۲۲ بهعلاوه یا منهای ۰٫۰۰۷۴. مقاله صراحتاً مزیت سامانهای UBE را در این معیار سطح مدل ادعا نمیکند.
UBE فقط منشأ زیرلایهای این نابرابری را هدف میگیرد و توازن داده، تخصیص اندازه واژگان، مرزبندی پیشتوکنساز یا قواعد ادغام را حل نمیکند. در تنظیم انگلیسیتنها با واژگان ۱۶هزارتایی، ۲۵۶ نماد اضافی باعث شد UBE فقط در ۳۷ از ۲۰۴ زبان توکن کمتری بدهد و در برخی زبانهای پرپوشش، از جمله گرجی و امهری، پسرفت کوچک دیده شد. نویسههای غیر-BMP و بسیاری از ایموجیها کاهش کف رمزگذاری ندارند. زبانهایی که بیشترین صرفهجویی درونذاتی را داشتند در پیکره آموزش مدلهای زبانی پاییندستی حضور نداشتند؛ UBE نیز جایگزین مستقیم نقاط بازرسی از پیشآموزشدیده نیست.
This summary relies on preprint arXiv:2610.01984v1, posted on October 1, 2026, which is after the current review date of this assessment (October 4, 2026). The paper is framed as a NeurIPS 2026 submission, but no evidence of completed independent peer review was found in the available material; its review status should therefore be described as unconfirmed, neither necessarily peer-reviewed nor fabricated. The paper studies token-budget disparity in UTF-8 byte-level BPE tokenizers: equivalent text in different scripts can consume very different token counts, affecting usable context, prompt-processing time, and cost under a fixed context window.
The method rests on the pre-merge ‘encoding floor,’ not a guarantee of final token counts. In standard BBPE, ASCII has a one-symbol floor; many Cyrillic, Arabic, and Hebrew characters have a floor of two; and CJK, Devanagari, and Thai characters have a floor of three. Universal Byte-Level Encoding, or UBE, routes each Unicode scalar value solely by its UTF-8 byte length: 1- or 2-byte characters stay on the UTF-8 path, while 3- or 4-byte characters are routed through UTF-16LE.
This lowers the floor for 3-byte Basic Multilingual Plane characters from 3 to 2, while ASCII remains at 1; 4-byte non-BMP characters still have a floor of 4. UBE uses two disjoint 256-symbol alphabets, one for UTF-8 and one in a Unicode Private Use Area block for UTF-16 bytes. BPE merge rules and selection, the absence of any language or script identification, and the Transformer architecture remain unchanged. The cost is 256 fewer merge slots than BBPE, roughly 0.8% overhead at a 32K vocabulary.
On FLORES-200, comprising 1,012 aligned sentences across 204 language-script configurations, UBE reduced the Gini coefficient of English-normalized token counts in every core 16K, 32K, and 64K comparison; relative reductions across the nine core comparisons ranged from 6% to 14%. In the main 101-language, 32K-vocabulary setting, Gini fell from 0.2183 to 0.1979, a 9.4% reduction, and UBE produced fewer tokens for 189 of 204 languages. Santali dropped 34.7% and Central Atlas Tamazight 31.9% in token count. At a 256K vocabulary, the Gini reduction narrowed to about 1.9%.
In additional robustness checks under the same 101-language/32K setting, Gini changed by about -11.1%, -8.5%, and +0.1% for UDHR, SIB-200, and MGSM, respectively. Because of public-text overlap, the authors treat UDHR as a stress test rather than a fully held-out corpus. In 182M-parameter, 32K-vocabulary language models, quality results were small and mixed: across three independent random seeds, held-out BPB Gini was effectively tied, at 0.1819 plus or minus 0.0052 for BBPE and 0.1822 plus or minus 0.0074 for UBE. The paper explicitly does not claim a systematic model-level advantage for UBE on this metric.
UBE targets only this substrate-level source of disparity; it does not resolve data balance, vocabulary-size allocation, pre-tokenizer boundary choices, or merge-rule design. Under the English-only/16K training setting, its extra 256 symbols meant UBE produced fewer tokens in only 37 of 204 languages, and small regressions appeared in some high-coverage languages, including Georgian and Amharic. Non-BMP characters and many emoji receive no encoding-floor reduction. The languages with the largest intrinsic token savings were absent from the downstream language-model training corpus, and UBE is not a drop-in replacement for existing pretrained checkpoints.
پژوهشهای بیشتری بخوان
مقالات بیشتر درباره هوش مصنوعی و پژوهشهای تازه را ببین.