LiteReality-Agent: بازسازی تعاملی صحنههای سهبعدی داخلی با عامل هوشمند
LiteReality-Agent اسکنهای RGB-D اتاق را با یک عامل کدنویس به صحنهای سهبعدی، قابلویرایش و آماده شبیهسازی تبدیل میکند. نتایج گزارششده در ۱۰ صحنه از بهبود شباهت بصری و سازگاری هندسی حکایت دارند، اما اعتبار پویایی فیزیکی در دنیای واقعی آزموده نشده است.
فهرست مطالب
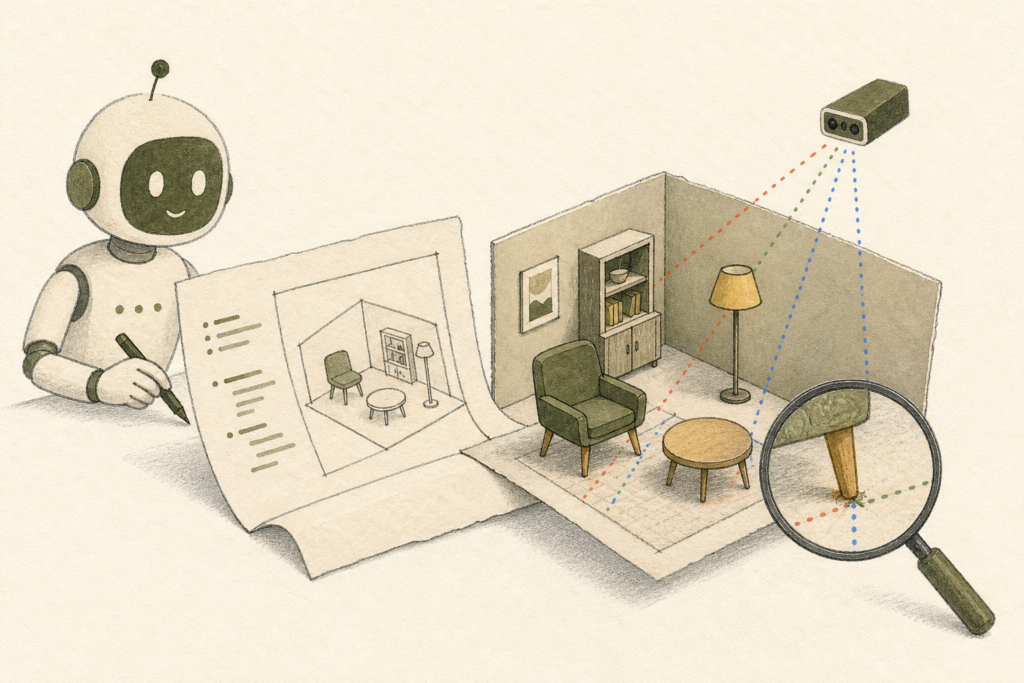
LiteReality-Agent سامانهای عاملی است که اسکنهای RGB-D اتاق، شامل رنگ، عمق و پارامترهای دوربین، را به صحنهای سهبعدی قابلتعامل و آماده شبیهسازی تبدیل میکند. ایده محوری مقاله، صورتبندی بازسازی بهعنوان کدنویسی است: عامل فایل پایتون Room.py را میخواند و ویرایش میکند و اجرای فایل صحنه را میسازد. بنابراین، این فایل فضای کاری پایدار، بازتولیدپذیر و قابلویرایش عامل است. منبع، پیشچاپ arXiv مورخ ۱ اکتبر ۲۰۲۶ است و داوری مستقل آن تأیید نشده است.
سامانه دو مرحله دارد. در «مقداردهی اولیه صحنه»، پوسته اتاق و جعبههای اشیای تشخیصدادهشده از داده اسکن دریافت میشوند. عامل چیدمان، قرارگیری بیرون اتاق، نفوذ در دیوار، تکیهگاه ناموجود و همپوشانی ناسازگار را بررسی و با جابهجایی یا تغییر اندازه محدود اصلاح میکند. سپس، اشیای ساختاریافته یا مفصلدار با تولید برنامهای ساخته میشوند و اشیای عمدتاً ایستا و پیچیده از نظر ظاهری با مدل تولید سهبعدی بازسازی میشوند. خروجی، صحنه اولیه در Room.py است.
در مرحله «تألیف عاملی»، عامل چرخه مشاهده، ویرایش و راستیآزمایی را اجرا میکند. ابزارها نماهای مناسب را انتخاب میکنند، رندر را با عکسهای کالیبره مقایسه میکنند، اندازهگیری متری و دوخت تصویر دیوار انجام میدهند و بافتهای PBR را دریافت میکنند. روند کار ابتدا مواد دیوار، سپس تجهیزات و نور، اشیای کوچک و در پایان هندسه، ظاهر و مفصلهای داراییهای برنامهای را اصلاح میکند. هر تغییر در کد ذخیره و دوباره ساخته میشود تا مقایسه، ویرایش فعلی را بازتاب دهد.
کنترل کیفیت فقط شباهت تصویری نیست. نشستها سقف نوبت و فراخوانی ابزار دارند و در ۱۰ درصد پایانی فراخوانیها، کاوش و خودبازبینی غیرفعال میشود تا ویرایشها تکمیل شوند. سپس سامانه برخورد مشها و تکیهگاه اشیا را جداگانه میسنجد. همپوشانی جعبه صندلی و میز لزوماً خطا نیست، اما تقاطع سطوح مش خطا محسوب میشود. اشیای بدون مهار با تصحیحهای محدود جابهجا و دوباره بررسی میشوند. صحنه با جرم، اینرسی، هندسه برخورد و مفصلها به MuJoCo صادر میشود؛ برخی خواص فیزیکی تألیفی یا برآوردیاند.
ارزیابی بر ۱۰ صحنه داخلی و ۶۲۰ نمای ثبتشده انجام شده است. در مقایسه با LiteReality و عاملهای عمومی GPT-6 در Codex و Fable 5.1 در Claude Code، LiteReality-Agent بهترین میانگینهای بصری گزارششده را دارد: SSIM برابر ۰٫۶۱۰۵، PSNR برابر ۱۴٫۱۲۹ دسیبل، RMSE برابر ۰٫۲۰۳۳ و LPIPS برابر ۰٫۵۳۹۲. خطای مطلق میانگین عمق آن در ۶۱۱ فریم ۱۰٫۵۰ سانتیمتر بود. هر ۸۶ شیء مبلمان شناساییشده تماس نزدیک با تکیهگاه داشتند و تقاطع سطحی میان زوجهای مبلمان تشخیص داده نشد.
محدودیتها اساسیاند. خواص فیزیکی عمدتاً از استنباط مدل زبانی، رده شیء، پیشفرضهای ماده یا هندسه برآورد میشوند و اندازهگیری مرجع ندارند؛ بنابراین، خروجی MuJoCo و نمایش تعامل ربات، بازتولید پویایی واقعی را اثبات نمیکنند. خطاهای اندازه یا موقعیت در تشخیصهای RoomPlan نیز ممکن است به بازسازی منتقل شوند و آزمون برخورد، تکیهگاه یا شباهت تصویری، صحت چیدمان واقعی را تضمین نمیکند. ارزیابی ادراکی نیز نمونهای کوچک، پوشش صحنه نامتوازن و امتیازهای وابسته دارد و معناداری آماری یا اعتبار فیزیکی را ثابت نمیکند.
LiteReality-Agent is an agentic system that turns RGB-D room scans, including colour, depth, and camera parameters, into interactive and simulation-ready 3D scenes. Its central idea is to formulate reconstruction as coding: an agent reads and edits a Python file, Room.py, and executing that file builds the scene. The file is therefore the agent’s persistent, reproducible, and editable workspace. The source is an arXiv preprint dated 1 October 2026, and its independent peer-review status has not been confirmed.
The system has two stages. During “scene initialisation,” the room shell and detected object boxes are obtained from scan data. A layout agent checks and repairs placements outside the room, wall penetrations, missing supports, and incompatible overlaps through bounded translations or resizing. Structured or articulated objects are then created through procedural generation, whereas visually complex and mostly static objects are reconstructed with a 3D generation model. The result is an initial scene in Room.py.
During “agentic authoring,” the agent runs an observe–edit–verify loop. Its tools select informative views, compare renders with calibrated photographs, perform metric measurement and wall-image stitching, and retrieve PBR textures. The workflow successively refines wall materials, fixtures and lighting, small objects, and finally the geometry, appearance, and articulation of procedural assets. Every change is saved in code and rebuilt, so the comparison reflects the current edit.
Quality control is not only image similarity. Sessions have turn and tool-call limits, and exploration and self-checking are disabled during the final 10% of tool calls so edits can be completed. The system then separately assesses mesh collisions and object support. Bounding-box overlap between a chair and table is not necessarily an error, whereas intersecting mesh surfaces are treated as one. Unanchored objects receive bounded corrections and are rechecked. The scene is exported to MuJoCo with mass, inertia, collision geometry, and joints; some physical properties are authored or estimated.
Evaluation covers 10 indoor scenes and 620 recorded views. Compared with LiteReality and the general-purpose GPT-6-in-Codex and Fable 5.1-in-Claude-Code agents, LiteReality-Agent reports the best mean visual metrics: 0.6105 SSIM, 14.129 dB PSNR, 0.2033 RMSE, and 0.5392 LPIPS. Its depth mean absolute error was 10.50 cm over 611 frames. All 86 identified furniture objects had near contact with support, and no surface intersection between furniture pairs was detected.
The limitations are substantial. Physical properties are largely estimated from language-model inference, object categories, material priors, or geometry, without reference measurements; consequently, MuJoCo output and robot-interaction demonstrations do not establish reproduction of real-world dynamics. Size or pose errors in RoomPlan detections may also propagate into reconstruction, while collision, support, and image-similarity checks do not guarantee true layout accuracy. The perceptual evaluation also has a small sample, uneven scene coverage, and dependent ratings, and therefore does not establish statistical significance or physical validity.
پژوهشهای بیشتری بخوان
مقالات بیشتر درباره هوش مصنوعی و پژوهشهای تازه را ببین.