PerMIT: حفاظت از حافظه پایدار عاملهای زبانی با تأیید محتوا و اعتماد جمعی
PerMIT معماری حافظهای برای عاملهای LLM است که محتوای محیطیِ تأییدنشده را پشت دروازه تأیید نگه میدارد، هسته مشخصی از تضمینهای تککاربره آن را در Lean 4 ماشینبررسی میکند و برای حافظه مشترک، اعتماد مبتنی بر تأییدهای ثبتشده پیشنهاد میدهد.
فهرست مطالب
این معرفی بر نسخه پیشچاپ arXiv:2610.28987v1، مورخ ۲۰ اکتبر ۲۰۲۶، تکیه دارد؛ وضعیت داوری مستقل آن در متن تأیید نشده است. مقاله مسئله حافظه پایدار در عاملهای مبتنی بر مدل زبانی بزرگ را بررسی میکند: محتوای وب، ابزارها، فایلها یا کد میتواند دستورهای تزریقی داشته باشد، در حافظه بماند و در جلسهای بعدی بر اقدام حساس عامل اثر بگذارد. PerMIT برای محدودکردن این مسیر، مرز اعتماد را در رابط حافظه قرار میدهد، نه در استدلال عامل.
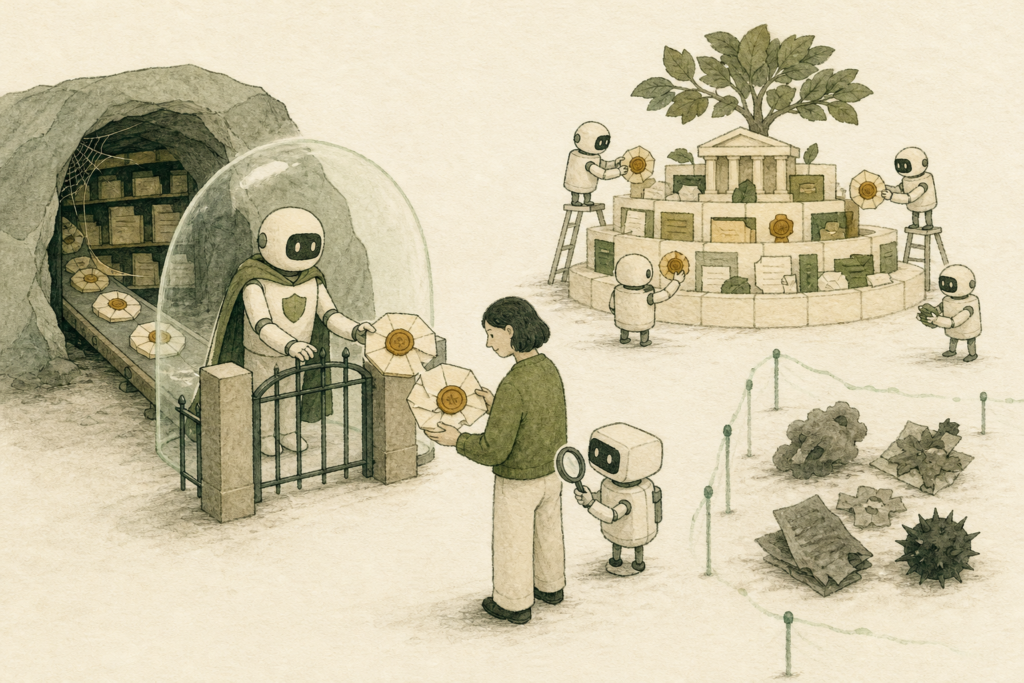
در لایه تککاربره، عامل محافظتشده، یا P-LLM، فقط از طریق رابطی با هفت عمل با حافظه کار میکند: نوشتن، فراخوانی، پرکردن، بلورسازی، نمایش، تأیید و حذف. محتوای محیطی و خلاصههای خواننده قرنطینهشده غیرقابلاعتماد میمانند و به P-LLM بهصورت شناسههای مبهم، نه متن خواندنی، عرضه میشوند. خواننده میتواند حافظه غیرقابلاعتماد را جستوجو کند اما توان فراخوانی ابزار ندارد. مقدار پس از نمایش مقدار، منبع، دستور کاربر و ابزار مقصد در دروازه تأیید قابل استفاده میشود.
مقاله دو خاصیت را صورتبندی میکند. یکپارچگی اقدام میگوید آرگومانِ ابزار حساس باید مقدار تایپشده کاربر یا مقداری باشد که همان کاربر با همان بایتها برای همان ابزار تأیید کرده است. یکپارچگی استدلال نسبت به رونوشت نمایش میگوید با یکسانبودن ورودی تایپشده، تصادف جفتشده، زمانبندی و رونوشت کامل نمایش، تفاوت حافظه غیرقابلاعتماد نباید رفتار P-LLM را تغییر دهد. هسته تککاربره در Lean 4 ماشینبررسی شده است، اما لایه فدرال و تحلیل احتمالاتی در این دامنه نیستند.
در لایه فدرال، هر تأیید پذیرش برای مقدار دقیق و ابزار، تأییدی امضاشده و ثبتشده برای همان مدخل میشود. پس از رسیدن به آستانه N تأیید تازه از هویتهای متمایز، مدخل تأییدشده توسط جامعه میشود و کاربران بعدی در مسیر تعریفشده تأیید دوباره نمیخواهند. رد واجد شرایط مدخل را فوراً حذف نمیکند؛ ارتقا را متوقف و داوری را به پنلی تقاضامحور میسپارد. کران ارتقای محتوای مسموم به دقت بازبین، ظرفیت مهاجم و تنظیمات آستانه و پنل وابسته است؛ این اعتماد درستی واقعی محتوا نیست.
در آزمایش Trojan Hippo، پیکربندیهای PerMIT با خود-راستیآزمایی و دو راستیآزمای سبک Qwen، در چهار مدل اصلی نرخ موفقیت حمله مشاهدهشده صفر داشتند؛ این نتیجه خطر صفر را اثبات نمیکند. شبیهسازی فدرال با پنج میلیارد تلاش ارتقا، جامعه ۱۲۰ کاربره و ۱۲۲ مدخل، میانگین تأییدهای لازم هر کاربر را ۲٫۳۶ مورد، یا ۳۸ درصد، کاهش داد. در τ²-bench، تا ۹۰ عامل خودمختار، هیچیک از ۱۲ محموله تزریق مستقیم تأییدشده توسط جامعه نشد و دانش ساختهشده برای Sonnet و Kimi در وظایف مخابراتی نگهداشتهشده بهبود معنادار گزارش کرد؛ بازه اثر GLM-5 شامل صفر بود.
محدودیتها بنیادیاند. تضمینها به برچسبگذاری منشأ، تغییرناپذیری بلوکها، نمایش وفادار و درستبودن تصمیم تأیید وابستهاند؛ دقت راستیآزمای LLM اثبات نشده است. تأیید به مقدار و ابزار گره خورده، نه به هدف، زمان، جایگاه آرگومان یا یک تراکنش کامل؛ بنابراین ترکیب مقادیر جداگانه تأییدشده میتواند نامناسب باشد. مقاله کانالهای زمانی، عامل یا واسط اجرایی سازشیافته، محتوای غیرقابلتشخیص برای بازبینها و جستوجوی تطبیقی محموله علیه راستیآزمای زنده را خارج از پوشش کامل میداند. در آزمایش بانکی نیز بهبود قابل تشخیصی نسبت به حالت بدون دانش گزارش نشد.
This introduction is based on the arXiv preprint version arXiv:2610.28987v1, dated October 20, 2026; its independent peer-review status is not confirmed in the text. The paper studies persistent memory in large-language-model agents: web content, tools, files, or code can contain injected instructions, remain in memory, and affect a sensitive agent action in a later session. PerMIT limits this route by placing the trust boundary at the memory interface rather than in the agent’s reasoning.
In the single-user tier, the protected agent, or P-LLM, accesses memory only through an interface with seven operations: write, recall, fill, crystallize, display, confirm, and evict. Environment-derived content and quarantined-reader summaries remain untrusted and are presented to the P-LLM as opaque handles rather than readable text. The reader can search untrusted memory but has no tool-calling capability. A value becomes usable after its value, source, user instruction, and target tool are displayed at the confirmation gate.
The paper formalizes two properties. Action Integrity states that an argument to a sensitive tool must be user-typed content or a value that the same user confirmed with the same bytes for that same tool. Reasoning Integrity modulo the display transcript states that, with identical typed inputs, coupled randomness, schedules, and complete display transcripts, differences in untrusted memory must not change P-LLM behavior. The single-user core is machine-checked in Lean 4, but the federated tier and probabilistic analysis are outside that scope.
In the federated tier, each accepted confirmation for an exact value and tool becomes a signed, logged endorsement for that entry. After reaching a threshold of N fresh endorsements from distinct identities, an entry becomes community-confirmed, and later users do not need repeated confirmation along the specified path. A qualifying rejection does not immediately delete the entry; it freezes promotion and sends the dispute to a demand-paced panel. The bound on poisoned-content promotion depends on reviewer accuracy, adversarial capacity, and threshold and panel settings; this trust does not mean factual correctness.
On Trojan Hippo, PerMIT configurations with self-verification and two lightweight Qwen verifiers recorded zero observed attack success across the four main models; this does not establish zero risk. A federated simulation with five billion promotion attempts, a 120-user community, and 122 entries reduced required approvals by 2.36 per user on average, or 38%. On τ²-bench, with up to 90 autonomous agents, none of 12 direct-injection payloads became community-confirmed, and constructed knowledge produced reported significant improvements on held-out telecom tasks for Sonnet and Kimi; GLM-5’s effect interval included zero.
The limitations are fundamental. The guarantees depend on source labeling, immutable blocks, faithful display, and sound confirmation decisions; the accuracy of an LLM verifier is not proved. Confirmation is tied to a value and tool, not to purpose, time, argument position, or an entire transaction, so separately endorsed values may be combined inappropriately. The paper leaves timing channels, compromised agents or enforcement harnesses, poison unrecognizable to reviewers, and adaptive payload search against live verifiers outside complete coverage. In the banking experiment, it also reported no detectable improvement over the no-knowledge condition.
پژوهشهای بیشتری بخوان
مقالات بیشتر درباره هوش مصنوعی و پژوهشهای تازه را ببین.