ردهبندی چهارمحوری برای سامانههای RAG
این مرور، پژوهشهای RAG را در چهار محور کارایی، دفاع، تعاملپذیری و استدلال پیچیده سازمان میدهد و محدودیتهای مشترک آنها را برجسته میکند.
فهرست مطالب
این معرفی بر پیشچاپ arXiv با شناسه 2610.01936 تکیه دارد که ۱ اکتبر ۲۰۲۶ بارگذاری شده است. مقاله مروری درباره تولید افزوده با بازیابی، یا RAG، است: سامانهای که هنگام پاسخگویی اسناد بیرونی را همراه مدل زبانی بهکار میگیرد. در متن مقاله اشارهای به داوری همتا یا پذیرش در مجله یا کنفرانس نیست؛ این امر بهتنهایی نشانه بیاعتباری محتوا نیست، اما اجازه نمیدهد اثر «داوریشده» خوانده شود. وضعیت داوری مستقل این پیشچاپ تأییدنشده است.
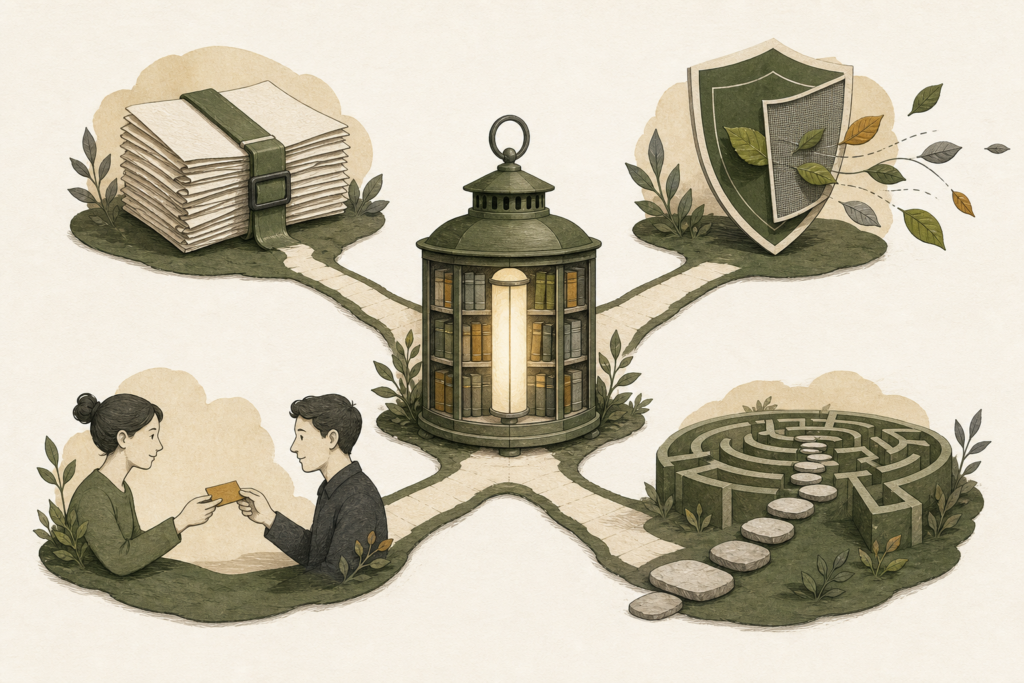
یافته محوری مقاله، سازماندهی ادبیات RAG در چهار محور است: فشردهسازی و کارایی، RAG دفاعی، تعاملپذیری کاربرمحور، و استدلال پیچیده و چندمرحلهای. نویسندگان RAG را خطلولهای یکنواخت نمیدانند، بلکه آن را مجموعهای از موازنههای طراحی معرفی میکنند: دقت در برابر هزینه محاسباتی؛ مقابله با مسمومسازی پیکره، تقویت سوگیری جمعیتی و نشت حریم خصوصی؛ سازگاری با نیت و سابقه کاربر؛ و بازیابی گامبهگام برای کاهش انباشت خطا در مسائل چندپرشی.
روش مرور، جستوجو در بازه ژانویه ۲۰۲۰ تا ژانویه ۲۰۲۵ در Google Scholar، Semantic Scholar و arXiv بود که با کلیدواژههای عمومی و موضوعی حدود ۷۸۰ رکورد را در مرحله شناسایی یافت. آثار باید خطلوله یکپارچه بازیابی و تولید، نوآوری روششناختی یا تجربی، معیارسنجی ویژه RAG، یا بررسی امنیت، پایداری، انصاف و ایمنی میداشتند. آثار فاقد بازیابی، مدلها یا بازیابهای مستقل بدون یکپارچگی، و مقالات بیسهم فنی یا تجربی کنار گذاشته شدند. دنبالکردن استنادها نیز بررسی تکمیلی تمرکزیافته بود، نه تکرار جستوجوی کامل.
در صورتبندی پایه، اسناد پیکره قطعهبندی، به بردار تبدیل و نمایهسازی میشوند؛ سپس چند قطعه برتر همراه پرسش به مدل مولد داده میشود. بازیابی تنک مانند BM25 بر همپوشانی واژگانی و بازیابی چگال مانند DPR بر تطبیق معنایی در فضای تعبیه تکیه دارد. مقاله تأکید میکند وزندهی softmax روی اسناد بازیابیشده الزامی جهانی نیست: فقط روی مجموعه برتر محاسبه میشود، خطاهای بازیابی اولیه را به ارث میبرد و استقلال شرطی اسناد را فرض میکند. سامانههای دیگر از الحاق ثابت top-k، بازرتبهبندی یا امتیازهای نقد استفاده میکنند.
در محور کارایی، هدف بیشینهسازی سودمندی هر سند نسبت به هزینه توکنی آن است؛ پالایش پرسش، بازیابی سلسلهمراتبی مانند RAPTOR و فشردهسازی شدید زمینه مانند xRAG نمونهاند. در محور دفاعی، اسناد سمی، سوگیر یا حساس با فیلتر، بازرتبهبندی و راستیآزمایی، مانند SELF-RAG و FILCO، حذف یا کموزن میشوند؛ خطر مسمومسازی پیکره و نشت حریم خصوصی نیز بررسی میشود. در تعاملپذیری، انتخاب سند به ارتباط پرسش، سابقه و بازخورد کاربر وابسته است. در استدلال پیچیده، بازیابی در هر گام تکرار میشود تا شواهد تازه نتیجههای میانی را اصلاح یا تکمیل کند.
مقاله تصریح میکند کیفیت و مقیاسپذیری بازیابی، توهم باقیمانده، سازگاری با دامنه و کاربر، تأخیر استقرار و فقدان شفافیت سرتاسری همچنان حلنشدهاند. شخصیسازی میتواند با دقت واقعیتمحور تعارض داشته باشد و در استدلال چندمرحلهای، خطای اولیه یا تجزیه نادرست پرسش تا پاسخ نهایی انباشته میشود. نویسندگان میگویند یک معیار واحد نمیتواند هر چهار محور را بسنجد، زیرا هزینه و تأخیر، تابآوری در برابر حمله، رضایت کاربر و صحت چندپرشی مبناهای سنجش متفاوتی دارند؛ بنابراین چارچوب مشترک با مسیرهای اختصاصی هر محور پیشنهاد میکنند. نتایج عددی گزارششده از پژوهشهای پیشین نقل شدهاند.
This overview is based on arXiv preprint 2610.01936, uploaded on 1 October 2026. The paper surveys Retrieval-Augmented Generation, or RAG: systems that use externally retrieved documents alongside a language model when answering. Its text does not mention peer review or acceptance at a journal or conference; that absence alone does not show the content is unreliable, but it does not permit describing the work as peer-reviewed. The independent peer-review status of this preprint remains unconfirmed.
The paper’s central finding is a four-axis organization of RAG literature: compression and efficiency, defensive RAG, user-centric interactivity, and complex multi-step reasoning. The authors do not treat RAG as a uniform pipeline, but as a set of design trade-offs: accuracy versus computational cost; countering corpus poisoning, amplified demographic bias, and privacy leakage; adapting to user intent and interaction history; and stepwise retrieval to reduce error accumulation in multi-hop tasks.
The review searched Google Scholar, Semantic Scholar, and arXiv from January 2020 through January 2025, identifying approximately 780 records at the initial stage through broad and targeted keywords. Included works needed an integrated retrieval-generation pipeline, methodological or empirical innovation, RAG-specific benchmarking, or study of security, robustness, fairness, or safety. Works without retrieval, standalone models or retrievers without integration, and papers without technical or empirical contribution were excluded. Citation tracing was a targeted completeness check rather than a repetition of the full search.
In the baseline formulation, corpus documents are chunked, embedded, and indexed; then top-ranked chunks are supplied with the query to the generator. Sparse retrieval such as BM25 relies on lexical overlap, while dense retrieval such as DPR relies on semantic matching in embedding space. The paper stresses that softmax weighting over retrieved documents is not universal: it operates only over the top-ranked set, inherits upstream retrieval errors, and assumes conditional independence among documents. Other systems use fixed top-k concatenation, reranking, or critique scores.
On the efficiency axis, the goal is maximizing each document’s utility relative to token cost; query refinement, hierarchical retrieval such as RAPTOR, and extreme context compression such as xRAG are examples. On the defensive axis, toxic, biased, or sensitive documents are filtered, reranked, or verified, as in SELF-RAG and FILCO; corpus poisoning risk and privacy leakage are also considered. Interactivity conditions document selection on query relevance, user history, and feedback. Complex reasoning repeats retrieval at each step so fresh evidence can correct or complete intermediate conclusions.
The paper states that retrieval quality and scalability, residual hallucination, domain and user adaptation, deployment latency, and missing end-to-end explainability remain unresolved. Personalization can conflict with factual accuracy, and in multi-step reasoning, early errors or poor question decomposition can accumulate into the final answer. The authors argue that one metric cannot assess all four axes, because cost and latency, adversarial robustness, user satisfaction, and multi-hop correctness rest on different measurement foundations; they instead propose a shared framework with axis-specific tracks. Reported numerical results are drawn from prior work.
پژوهشهای بیشتری بخوان
مقالات بیشتر درباره هوش مصنوعی و پژوهشهای تازه را ببین.