HydroJEV: غربالگری سریع برای نسبتدهی ناهنجاریهای شبکه آب
یک پیشچاپ، غربالگر بدونآموزش Jev را برای تفکیک علت هشدارهای SCADA در شبکههای آب میآزماید؛ داوری مستقل آن تأیید نشده است.
فهرست مطالب
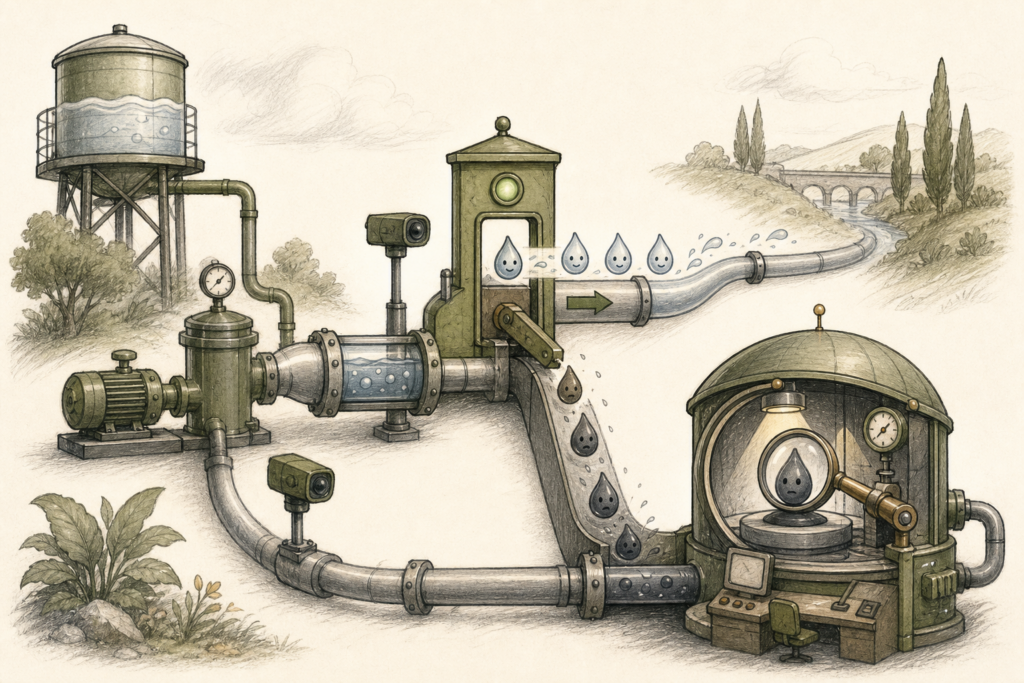
این معرفی بر پیشچاپ arXiv (نسخه ۱، ۱ اکتبر ۲۰۲۶) تکیه دارد که وضعیت داوری مستقل آن در متن مشخص نشده و در این معرفی داوریشده تلقی نمیشود. مقاله HydroJEV مسئله پس از هشدار SCADA در شبکه توزیع آب را بررسی میکند: آیا ناهنجاری ناشی از حمله سایبری، خرابی فیزیکی، گذرای عادی یا خطای حسگر است؟ نویسندگان Jev را غربالگری بدونآموزش معرفی میکنند که در حدود یک ثانیه احتمال گزینههای ثابت را بازمیگرداند و موارد حلنشده را به بررسی کندتر میفرستد.
آزمایش اصلی روی شبکه شبیهسازیشده C-Town در EPANET انجام شد. هر نمونه یک پنجره ششساعته SCADA از شبیهسازیهای ساعتی و متعلق به یکی از چهار کلاس بود. دادهها یک خانواده مرجع و سه خانواده رویداد دیدهنشده داشتند؛ خانواده C رویدادهای شبیهبههم، مانند توقف پمپ واقعی در برابر توقف جعلشده، را شامل میشد. در مجموع ۱٬۲۷۹ پنجره در چهار دور بسته و ازپیشثبتشده ارزیابی شد و هر مجموعه آزمون فقط یکبار تحلیل شد.
همه روشها شواهد یکسانی دریافت کردند: تنظیمات کنترل، بررسی سازگاری اندازهگیریها، ده باقیمانده بزرگ دوقلوی دیجیتال، خلاصه علامتدار و تراز دبی منبع. Jev با پرسشی ثابت و پنج گزینه، شامل «شواهد ناکافی»، کار کرد. خروجی آن با تصحیح پیشینِ بدونبرچسب، برآوردشده از ۴۰ پنجره توسعه، تنظیم شد. مقایسهها شامل درخت قواعد دستنویس R1، رگرسیون لجستیک نظارتشده R2 با ۲۰۰ نمونه برچسبدار، و هفت مدل زبانی ابری بود.
در چهار مجموعه درونتوزیع، macro-F1 تنظیمشده Jev از ۰٫۶۲۰ تا ۰٫۶۴۴ و میانگین آن ۰٫۶۳ بود؛ میانگین R1، ۰٫۵۹ بود و اختلافهای هر مجموعه معنادار نبودند. R2 با برچسب همه زیرنوعهای مشابه بهتر عمل کرد و میانگین ۰٫۹۱ داشت. اما هنگامی که زیرنوع رویداد از آموزش R2 حذف شد، Jev در هر چهار دور ۰٫۳۶۱ تا ۰٫۴۱۷ واحد macro-F1 بالاتر بود؛ همه این آزمونها پس از اصلاح هولم معنادار ماندند. R2 در دادههای درونتوزیع بهطور میانگین از حدود چهار نمونه برچسبدار برای هر کلاس به بعد از Jev پیشی گرفت.
زمان میانه محاسبه Jev حدود ۱٫۲۲ ثانیه بود؛ glm-5.2 و deepseek-v4-pro با ارسال تکبهتک درخواستها حدود ۲۰ تا ۴۰ برابر کندتر بودند. دو مدل زبانی پیشرو در برخی مجموعهها دقیقتر بودند. در آبشار پیشنهادی، فقط رأی خوشخیم Jev که R1 نیز تأیید میکرد پذیرفته میشد و سایر پنجرهها به داور زبانی میرفتند. در دو مجموعه تازه دور چهار، این دروازه ۳۴٫۵ و ۳۸٫۰ درصد پنجرهها را پذیرفت و آبشار glm-5.2 بدون افت macro-F1، در حاشیه عدمفرودستی ۰٫۰۳ نسبت به داور باقی ماند.
محدودیتها اساسیاند: همه پنجرهها شبیهسازیشدهاند و همان مدل هیدرولیکی هم رویدادها و هم دوقلوی دیجیتال را تولید کرده است؛ بنابراین خطای مدل در داده میدانی کامل بازنمایی نشده است. Jev در دستکاری پنهان ضعیفتر بود و میانگین یادآوری حمله سایبری آن در هشت مجموعه C-Town، ۰٫۳۴ گزارش شد. در خانواده دیدهنشده دور چهار، دروازه توافق برخی حملات و خرابیها را خوشخیم پذیرفت؛ آبشار قواعد بدون دروازه توافق نیز در مجموعههای تازه بر اجزای خود برتری نداشت. نویسندگان بر اعتبارسنجی روی رویدادهای شبیهسازیشده و سپس دادههای میدانی هر شبکه پیش از کاربرد عملی تأکید میکنند.
This introduction is based on an arXiv preprint (version 1, dated 1 October 2026) whose independent peer-review status is not stated in the text and is not treated as peer-reviewed in this introduction. HydroJEV examines the question that follows a SCADA alarm in a water distribution network: does an anomaly stem from a cyberattack, a physical fault, a normal transient, or a sensor fault? The authors present Jev as a training-free screen that returns probabilities over fixed options in about a second and sends unresolved cases to slower review.
The main experiment used the simulated C-Town network in EPANET. Each sample was a six-hour SCADA window from hourly simulations and belonged to one of four classes. The data contained a reference family and three unseen event families; family C included look-alike events, such as a real pump trip versus a spoofed stop. In total, 1,279 windows were evaluated in four sealed, preregistered rounds, and each test set was analysed only once.
All methods received the same evidence: control settings, measurement-consistency checks, the ten largest digital-twin residuals, a signed summary, and source-flow balance. Jev used a fixed five-option question that included “insufficient evidence.” Its output was adjusted using a label-free prior correction estimated from 40 development windows. Comparisons included the hand-written R1 rule tree, supervised logistic-regression model R2 with 200 labelled samples, and seven cloud LLMs.
Across four in-distribution sets, calibrated Jev achieved macro-F1 from 0.620 to 0.644, averaging 0.63; R1 averaged 0.59, and individual-set differences were not significant. R2 performed better when trained on labels covering all similar subtypes, averaging 0.91. However, when the evaluated subtype was removed from R2 training, Jev was ahead by 0.361 to 0.417 macro-F1 points in all four rounds; every test remained significant after Holm correction. On in-distribution data, R2 surpassed Jev on average from about four labelled examples per class onward.
Jev’s median compute time was about 1.22 seconds; glm-5.2 and deepseek-v4-pro were roughly 20 to 40 times slower when requests were sent one at a time. Two frontier LLMs were more accurate on some sets. In the proposed cascade, only a benign Jev verdict also confirmed by R1 was accepted, while other windows went to an LLM reviewer. On the two fresh round-4 sets, the gate accepted 34.5% and 38.0% of windows, and the glm-5.2 cascade stayed within the 0.03 non-inferiority margin of its reviewer without loss of macro-F1.
The limitations are substantial. All windows were simulated, and the same hydraulic model generated both events and the digital twin; thus model error in field data is not fully represented. Jev was weaker on concealed manipulation, with mean cyberattack recall of 0.34 across eight C-Town sets. In the unseen round-4 family, the agreement gate accepted some attacks and faults as benign; the rule cascade without the agreement gate also did not outperform its own components on fresh sets. The authors stress validation on simulated events and then field data from each network before practical use.
پژوهشهای بیشتری بخوان
مقالات بیشتر درباره هوش مصنوعی و پژوهشهای تازه را ببین.