Argo-Bench: سنجش عاملهای دادهای در گردشکارهای سازمانی
آرگو-بنچ محیطی شبیهسازیشده برای ارزیابی عاملهای دادهای است که باید در یک انبار داده ERP بزرگ جستوجو کنند، تحلیل انجام دهند و نتیجه را بهصورت اقدام یا گزارش ثبت کنند.
فهرست مطالب
این مقاله با موضوع اصلی عاملهای دادهای، پیشچاپ arXiv مورخ ۱ اکتبر ۲۰۲۶ است و «در حال بررسی» معرفی میشود؛ با این حال، داوری مستقل آن تأیید نشده است. نویسندگان ارزیابی عاملهایی را مطرح میکنند که فراتر از تولید SQL، دادههای پراکنده سازمانی را کاوش و تفسیر میکنند، تحلیل انجام میدهند و نتیجه را به اقدام یا ثبت خروجی تبدیل میکنند. تمرکز مقاله، ارزیابی AI Agent در کار دادهای است.
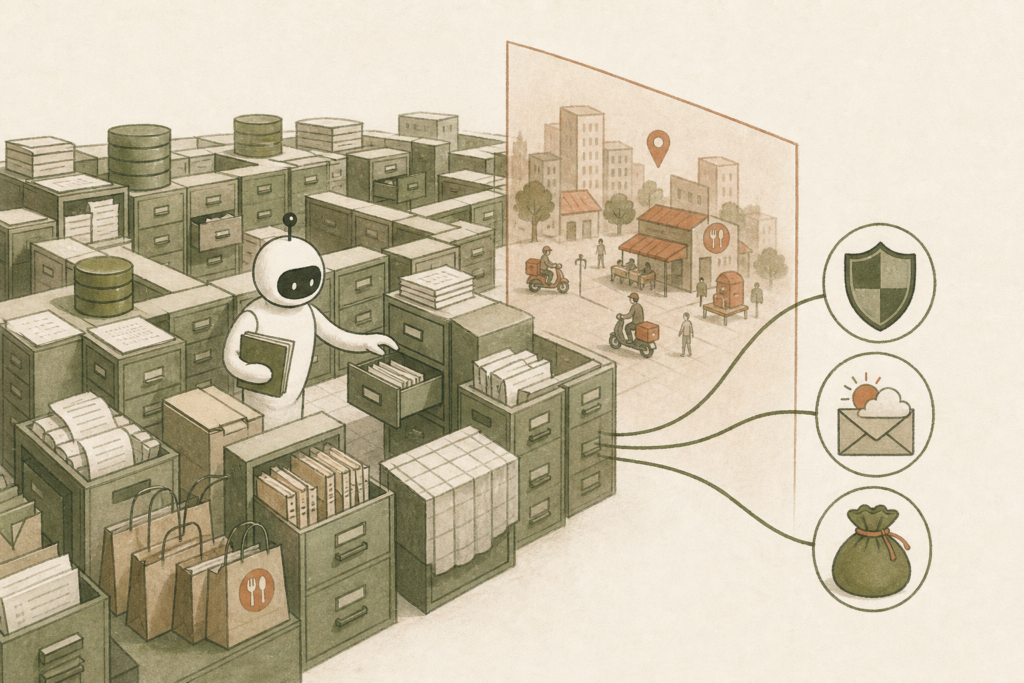
آرگو-بنچ یک پلتفرم تحویل غذا در نیویورکِ سال ۲۰۲۴ را شبیهسازی و به انبار Oracle E-Business Suite 12.2 صادر میکند. انبار ارزیابی ۲۳۵ جدول و ۷٫۴۹ میلیارد ردیف دارد و جهان شبیهسازیشده شامل ۸۱ میلیون سفارش و ۳٫۴ میلیون مشتری فعال است. عامل به حالت پنهان شبیهساز دسترسی ندارد؛ پس باید واقعیتها را از جداول، روابط حسابداری و رکوردهای عملیاتی بازسازی کند. حالت پنهان فقط برای نمرهدهی به کار میرود.
این بنچمارک ۲۱۰ وظیفه در پنج حوزه اعتماد و ایمنی، برنامهریزی و تحلیل مالی، بازارگاه، حسابداری و رشد دارد. وظایف مسدود کردن حسابهای متقلب، پیشبینی پرداخت، تخصیص بودجه مشوق پیکها، گزارش ارقام مالی و انتشار داده داشبورد را دربر میگیرند. عامل به SQL فقطخواندنی، محیط پایدار پایتون و کتابخانههای آمار، یادگیری ماشین و بهینهسازی دسترسی دارد، اما اینترنت خروجی ندارد. خروجیها از طریق رابط Mission Control ثبت میشوند.
روش نمرهدهی بر پیامد ثبتهای عامل تکیه دارد، نه فقط تطابق با پاسخ متنی یا پرسوجوی طلایی. پیشبینیها با ماههای پنهان و امتیاز بازهای وزندار ارزیابی میشوند. فهرستهای مسدودسازی بر پایه زیان تقلب پیشگیریشده، هزینه بررسی و زیان مسدودسازی نادرست امتیاز میگیرند؛ برنامههای بودجه نیز در مدل پاسخ شبیهساز سنجیده میشوند. مقاله میگوید برای هر وظیفه راهحلی مرجع و اجرایی وجود دارد که حلپذیری آن تنها با انبار را نشان میدهد.
نویسندگان ۱۴ مدل مرزی و دارای وزنباز را ارزیابی کردهاند. در تنظیمات گزارششده، Claude Opus 5.5 با میانگین ۵۹٫۵ از ۱۰۰ و نرخ حل ۳۴٫۸ درصد برای وظایف با امتیاز دستکم ۹۵، بهترین نتیجه را دارد. GPT-6 Astra در پیشبینی و Claude Sonnet 5.5 در انطباق پیشتاز گزارش شدهاند. شکستها غالباً به انتخاب رکورد، کمیت یا تابع هدف نادرست نسبت داده میشوند. در ۴٬۵۵۳ سری، بازههای اسمی ۸۰ درصدی فقط ۴۴٫۸ درصد مقدارهای تحققیافته را پوشاندند.
محدودیتها برای تفسیر نتایج تعیینکنندهاند: جهان فقط یک شهر، یک سال و یک قالب ERP را پوشش میدهد؛ ارز خارجی، چند کسبوکارِ ترکیبشده و ناسازگاریهای رایج انبارهای واقعی را ندارد. شبیهساز بر ۲۳ معیار اعتبارسنجی شده، اما برنامه عضویت بر فرضهایی با پشتوانه ضعیفتر است. هر تنظیم مدل برای هر وظیفه یک بار اجرا شده و همه وظایف از یک جهان میآیند؛ بنابراین مقاله عملکرد عاملها در انبار یک شرکت واقعی را برآورد نمیکند.
This paper, whose main subject is data agents, is an arXiv preprint dated October 1, 2026 and is described as “under review.” Its independent peer-review status has not been confirmed. The authors evaluate agents that go beyond generating SQL: they explore and interpret dispersed enterprise data, perform analysis, and convert results into actions or filed outputs. The paper’s focus is therefore AI-agent evaluation for data work.
Argo-Bench simulates a New York City food-delivery platform in 2024 and exports it to an Oracle E-Business Suite 12.2 warehouse. The evaluation warehouse has 235 tables and 7.49 billion rows, while the simulated world contains 81 million orders and 3.4 million active customers. Agents cannot access the simulator’s latent state, so they must reconstruct facts from tables, accounting relationships, and operational records. The latent state is used only for grading.
The benchmark contains 210 tasks in five areas: trust and safety, financial planning and analysis, marketplace, accounting, and growth. Tasks include banning fraudulent accounts, forecasting payments, allocating courier-incentive budgets, reporting financial figures, and publishing dashboard data. Agents have read-only SQL, a persistent Python environment, and statistics, machine-learning, and optimization libraries, but no outbound internet access. Outputs are filed through the Mission Control interface.
The grading method is based on the consequences of an agent’s filings rather than only matching a textual answer or gold query. Forecasts are evaluated against hidden months using weighted interval scores. Ban lists are scored using prevented fraud losses, review costs, and losses from incorrect bans, while budget plans are assessed in the simulator’s response model. The paper states that every task has an executable reference solution demonstrating solvability from the warehouse alone.
The authors evaluate 14 frontier and open-weight models. In the reported settings, Claude Opus 5.5 obtains the best result, with a mean score of 59.5 out of 100 and a 34.8% solved rate for tasks scoring at least 95. GPT-6 Astra is reported to lead forecasting, and Claude Sonnet 5.5 leads compliance. Failures are often attributed to selecting the wrong record, quantity, or objective. Across 4,553 series, nominal 80% intervals covered realized values only 44.8% of the time.
The limitations are consequential for interpretation. The world covers only one city, one year, and one ERP format; it lacks foreign currencies, combined multi-business operations, and the common inconsistencies of real warehouses. The simulator is validated on 23 metrics, but the membership program relies on more weakly grounded assumptions. Each model setting is run once per task and all tasks come from one world, so the paper does not estimate agent performance in a real company warehouse.
پژوهشهای بیشتری بخوان
مقالات بیشتر درباره هوش مصنوعی و پژوهشهای تازه را ببین.