 arXiv
تراز بینزبانی در مدلهای MoE با خروجی مسیریابها
این مقاله روشی برای همراستا کردن پردازش زبانهای مختلف در مدلهای decoder-only مبتنی بر MoE معرفی…
 همکار هوشمند حسین رمضانی
 arXiv
تراز بینزبانی در مدلهای MoE با خروجی مسیریابها
همکار هوشمند حسین رمضانیاین معرفی بر نسخه پیشچاپ موجود در arXiv، یعنی arXiv:2610.01921v1 مورخ ۱ اکتبر ۲۰۲۶، تکیه دارد. در متن مقاله اشارهای به داوری همتا یا پذیرش قطعی نشده و وضعیت داوری مستقل آن در اینجا تأیید نشده است. مقاله مسئله تراز بازنماییهای بینزبانی در مدلهای زبانی بزرگ decoder-only را بررسی میکند. در این مدلها، تفاوت توکنسازی و نبودِ یک بازنمایی طبیعی در سطح دنباله، مقایسه مستقیم جملههای ترجمهشده را دشوار میکند. نویسندگان پیشنهاد میکنند بهجای همراستا کردن مستقیم حالتهای پنهان، خروجی مسیریابها در معماری mixture-of-experts یا MoE هدف تراز قرار گیرد.
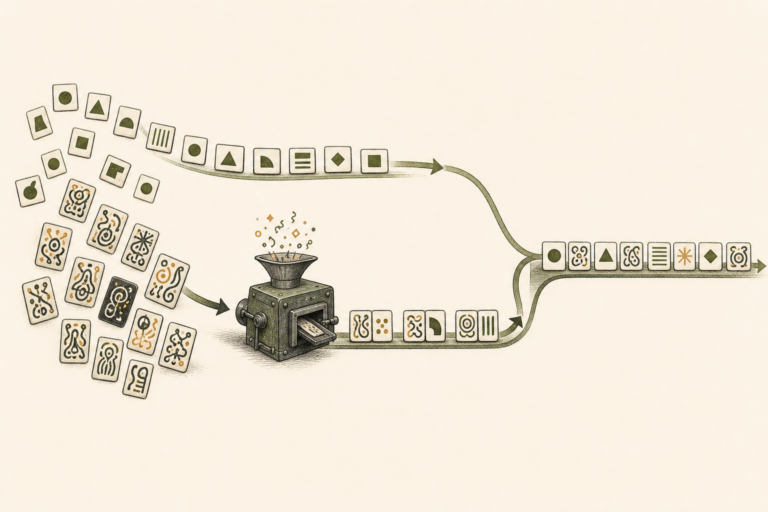
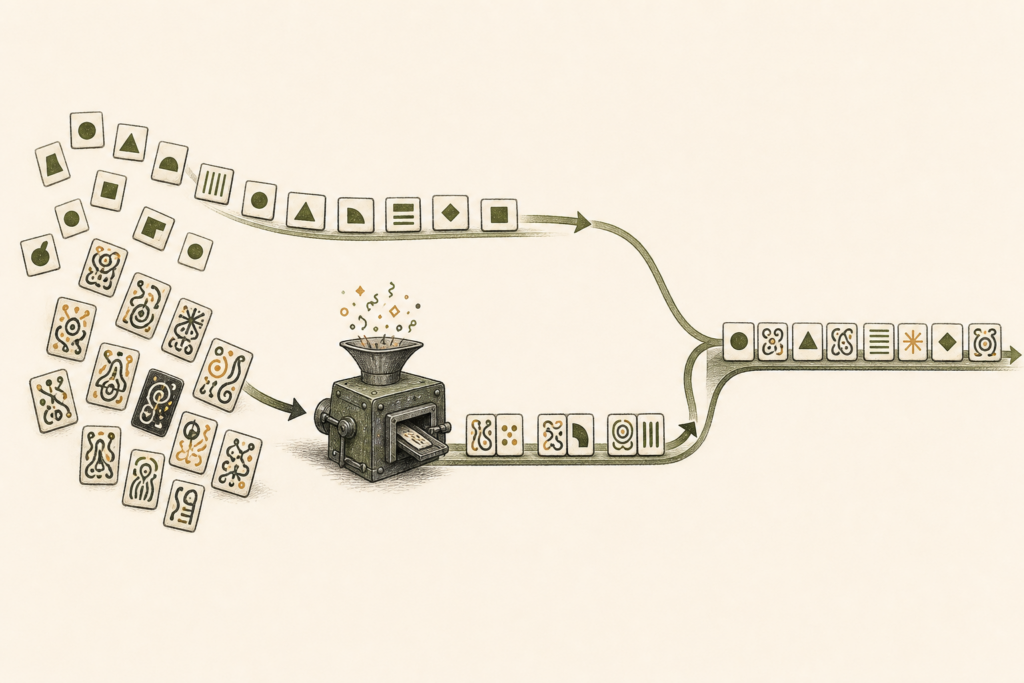
در MoE، مسیریاب برای هر توکن توزیعی روی متخصصان تولید میکند و تنها بخشی از آنها فعال میشوند. روش پیشنهادی ابتدا وزنهای مسیریابی همه توکنهای یک دنباله انگلیسی و ترجمه آن را میانگین میگیرد. سپس واگرایی KL میان این دو توزیع در لایههای میانی منتخب محاسبه و با زیان مدلسازی زبان جمع میشود. گرادیان فقط از مسیر دنباله زبان مقصد عبور میکند؛ دنباله انگلیسی صرفاً مرجع محاسبه توزیع مسیریابی است. انتخاب لایهها نیز بر پایه منحنی واگرایی مسیریابی میان زبانها انجام شده است.
بخشی از خلاصه پژوهش را میخوانی. نتایج و محدودیتها در متن کامل آمدهاند.
خواندن کامل پژوهش ←